QA 관측(Observability) 스택 구축기 — Prometheus로 긁고 Grafana로 본다
QA 환경에 관측(observability) 스택을 세웠다. 각 서버가 자기 상태를 포트로 노출하면, Prometheus가 주기적으로 긁어(pull) 저장하고, 팀원이 운영하는 Grafana에서 본다. 이상하면 Alertmanager가 Slack으로 알린다.
- 리전
ap-northeast-2· 구성 mon 박스(Prometheus·Alertmanager·Grafana) + GPU 박스 + 백엔드 ASG + 팀원 observability VPC - 코드·설정에서 계정 번호 자리는
<계정ID>, 사설 IP는 실제 값(내부망이라 공개해도 무방한 선)으로 둔다. - 이 글은 전체 그림이다. 조각마다 개념을 어떻게 이해했고 어디서 막혔는지는 이어지는 글들에서 하나씩 파고든다.
전체 그림 — 누가 긁고 누가 보나
핵심 역할 분담은 넷이다.
- exporter(node_exporter·cAdvisor·DCGM): 서버/컨테이너/GPU 상태를 HTTP 포트로 노출만 한다
- Prometheus: 그 포트들을 일정 주기로 긁어(scrape/pull) 시계열 DB(TSDB)에 저장한다
- Grafana: Prometheus를 datasource로 삼아, 사람이 볼 때 질의해서 그린다
- Alertmanager: 규칙에 걸리면 Slack으로 통지한다
flowchart LR
    subgraph QA["QA VPC (10.76.x)"]
        direction TB
        N["mon 박스<br/>node·cAdvisor"]
        GPU["GPU 박스<br/>node·cAdvisor·DCGM"]
        BE["백엔드 ASG<br/>node·cAdvisor<br/>(ec2_sd로 발견)"]
        P["Prometheus<br/>(mon 박스)"]
        AM["Alertmanager"]
        N -->|scrape| P
        GPU -->|scrape| P
        BE -->|scrape| P
        P --> AM
    end
    subgraph OBS["observability VPC (10.78.x)"]
        G["Grafana"]
    end
    G -->|"datasource: VPC peering 넘어 pull"| P
    AM -->|webhook| SL["Slack"]
왜 pull인가 — Prometheus는 각 exporter에게 “지금 지표 내놔”라고 먼저 당긴다. exporter는 포트만 열고 기다릴 뿐 어디로 보내지 않는다. 그래서 대상이 늘어도 Prometheus 설정에 “누구를 긁을지”만 추가하면 된다. 그리고 Prometheus는 상시 고정 주기로 긁고, Grafana는 사람이 볼 때만 질의한다 — 그래서 scrape가 훨씬 잦다.
아래가 실제로 긁고 있는 타겟 목록이다.
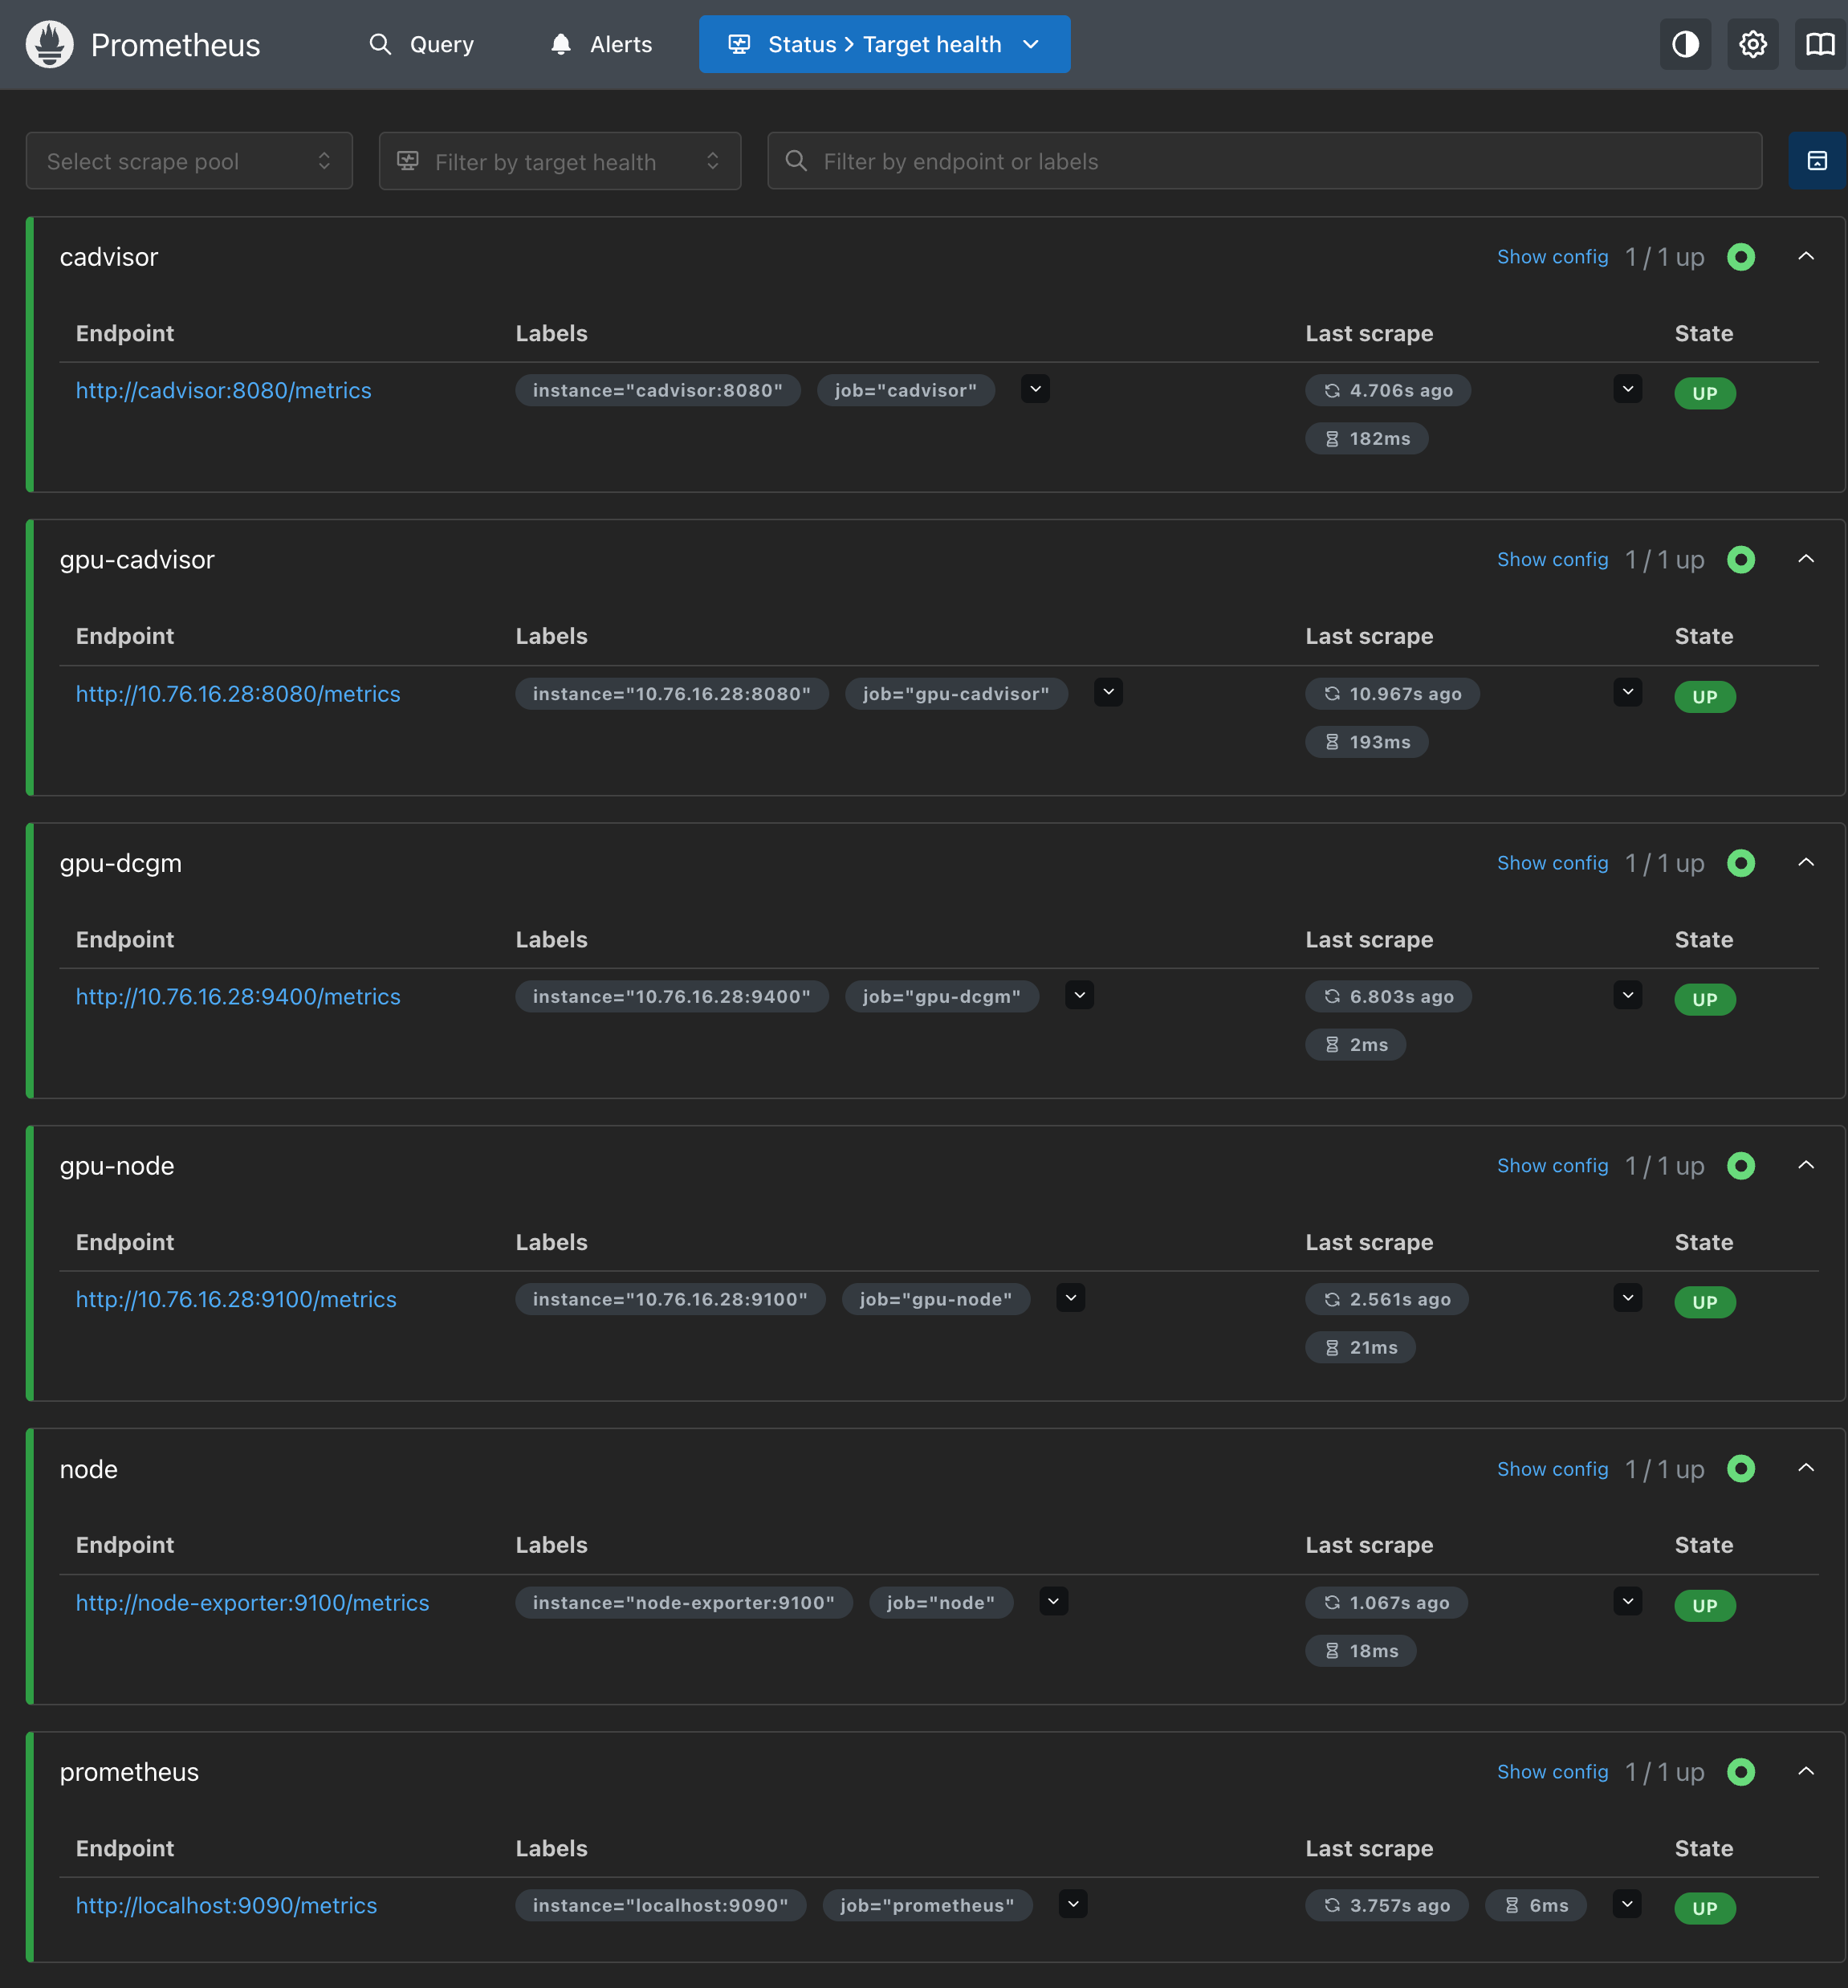
Target health — 6개 전부 UP — node·cadvisor(mon 자신), gpu-node·gpu-cadvisor·gpu-dcgm(GPU 박스), prometheus(자기 자신). 여기에 뒤에서 백엔드가 ec2_sd로 더 붙는다.
1. Prometheus 풀 스택 구축
mon 전용 박스 하나에 docker compose로 다섯 개를 띄웠다 — node_exporter·cAdvisor·Prometheus·Grafana·Alertmanager. node_exporter는 호스트(CPU/메모리/디스크), cAdvisor는 컨테이너별 상태를 노출하고, Prometheus가 둘을 긁는다.
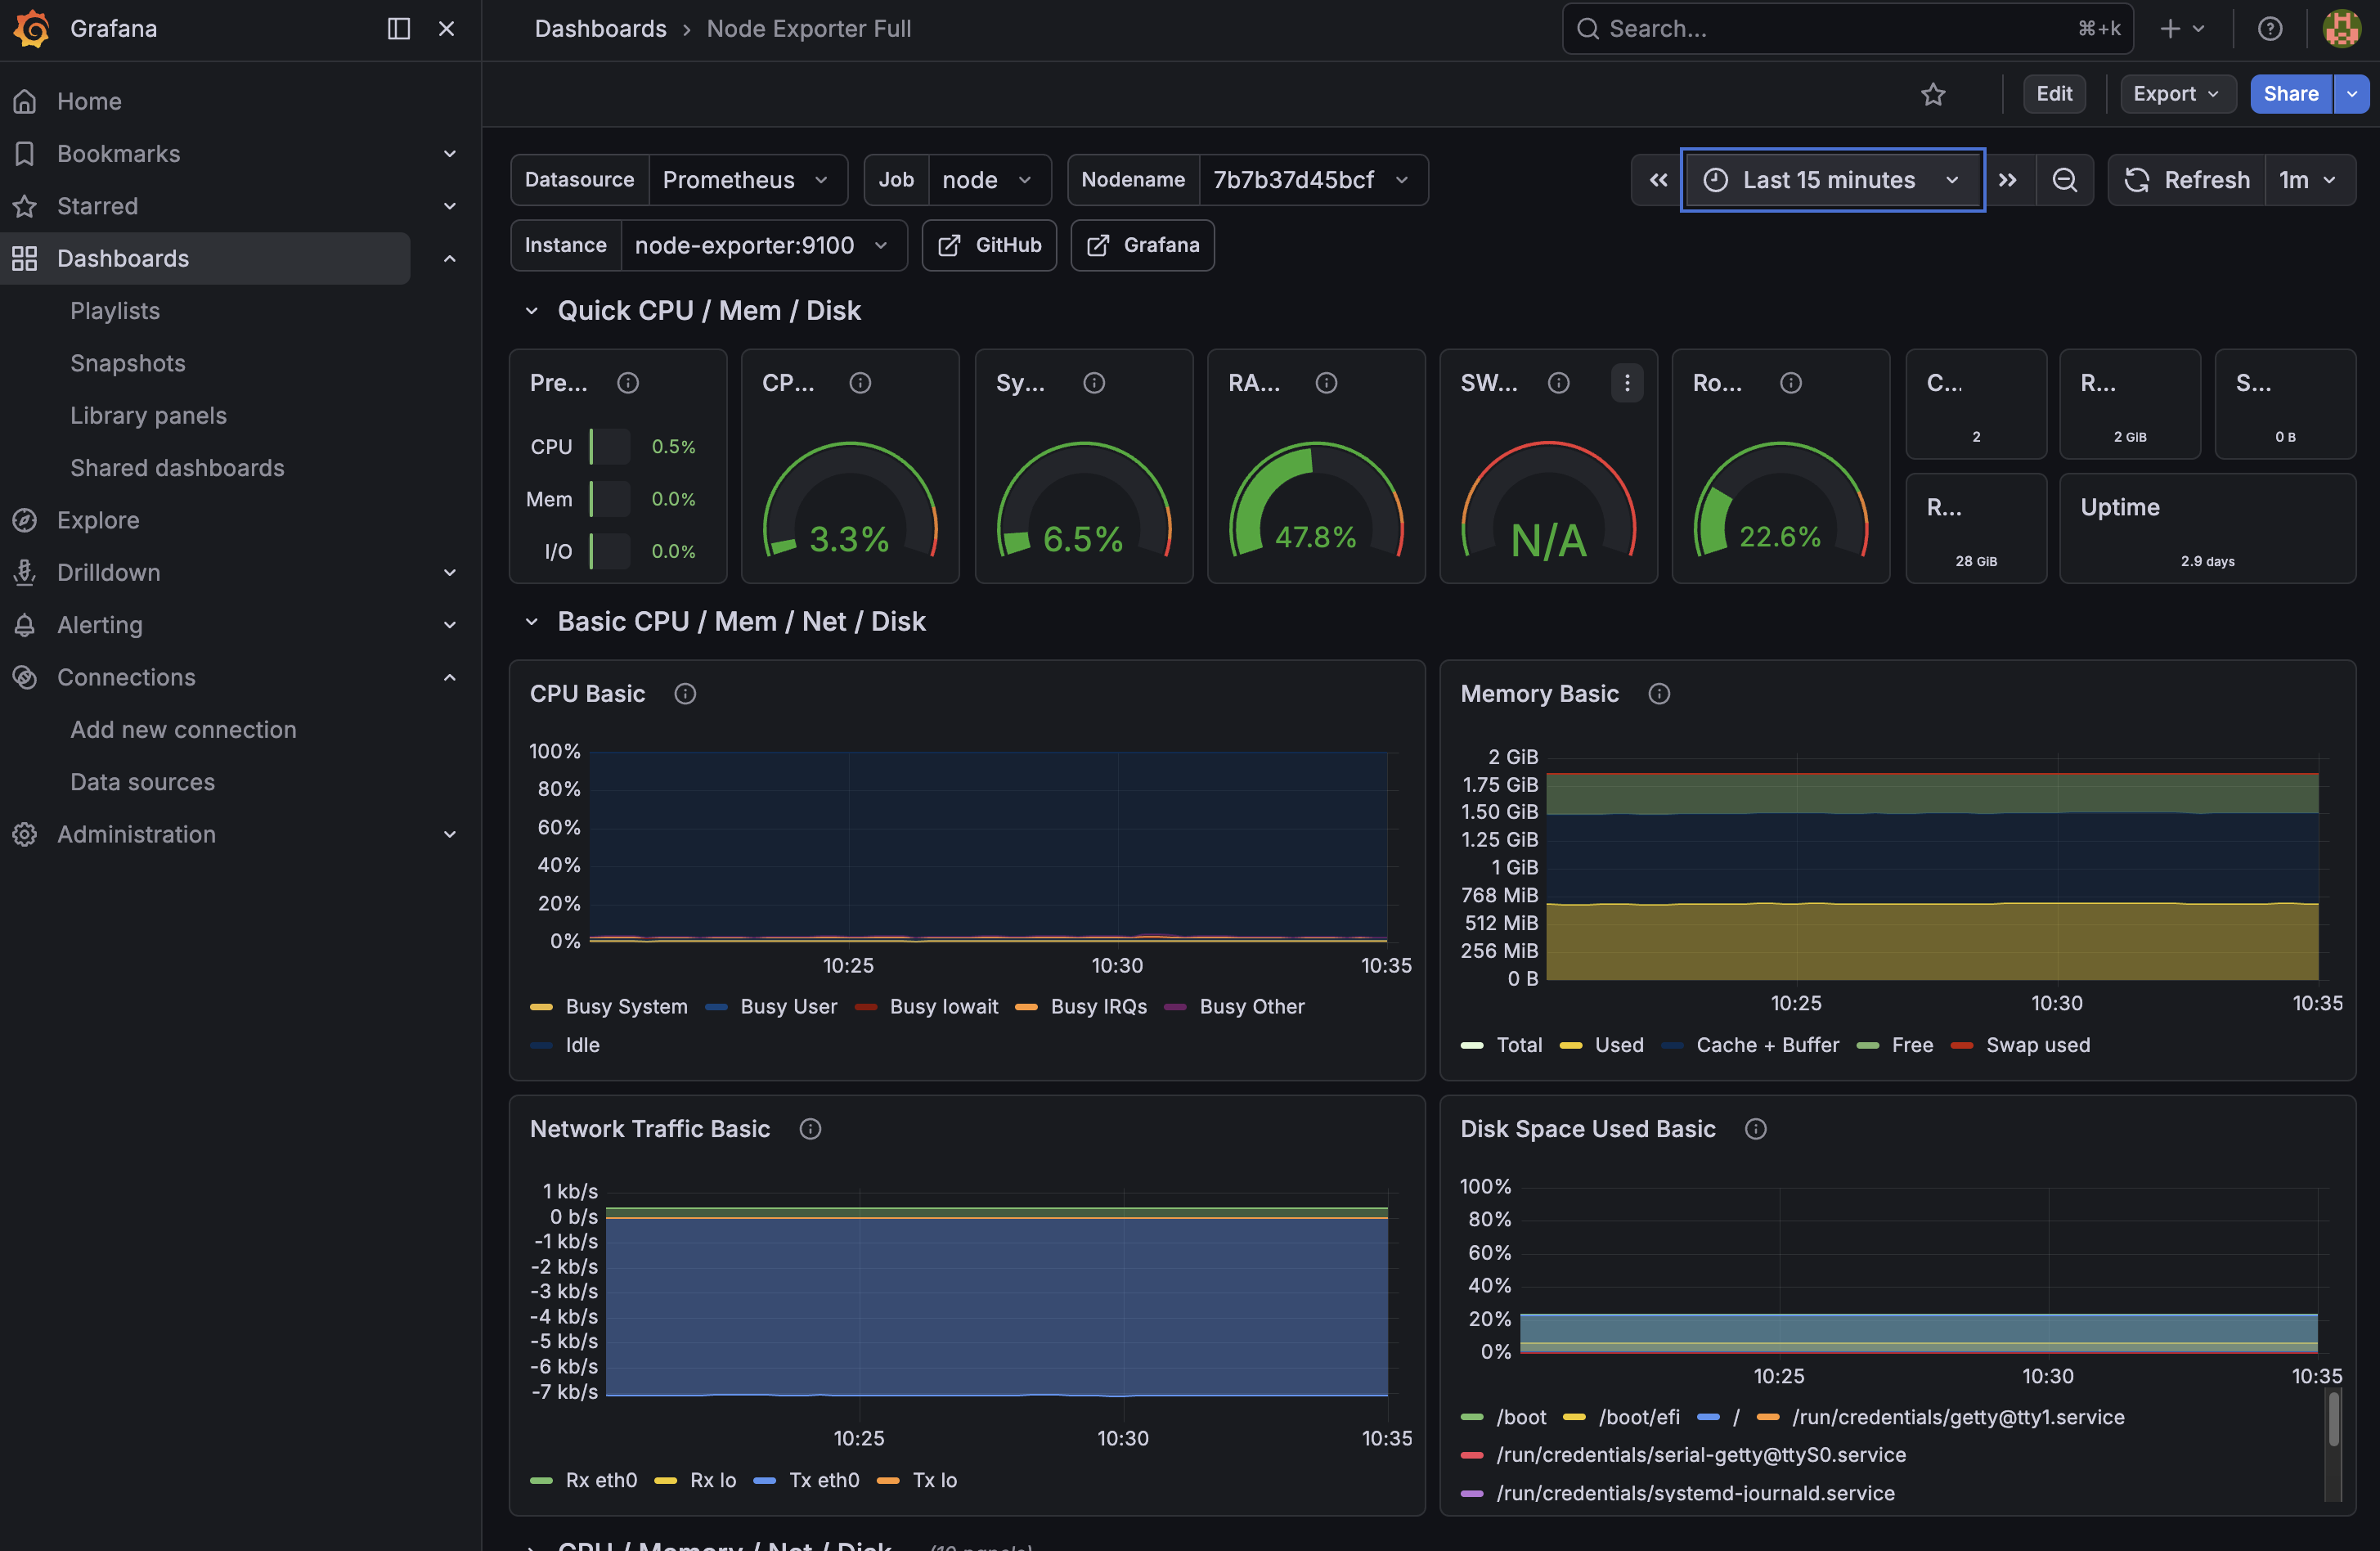
대시보드 1860 (Node Exporter Full) — node_exporter 지표를 그대로 보여주는 공식 대시보드. 직접 패널을 그리지 않아도 import 한 번으로 호스트 상태가 다 보인다.
수집(label 붙이기)은 Prometheus가 하고, Grafana는 표시만 한다. “어느 서버 것인지”를 가르는
job/instance라벨은 Prometheus가 긁을 때 찍는다 — Grafana가 만드는 게 아니다.
2. 팀원의 observability VPC에 연결
팀원이 전용 관측 VPC(Grafana + Loki/Tempo)를 따로 운영하고 있었다. 내 Prometheus를 어디에 둘지 두 선택지가 있었다.
- (A) QA에 Prometheus를 그대로 두고, 팀원 Grafana에 datasource로만 연결
- (B) mon 박스를 통째로 관측 VPC로 이전
결정: A. 팀원 Grafana가 이미 있어 이전하면 Grafana가 중복되고, scrape(15초 주기)는 QA 로컬에 두는 게 피어링을 덜 타서 유리하다(피어링은 Grafana의 가끔 질의만 넘는다).
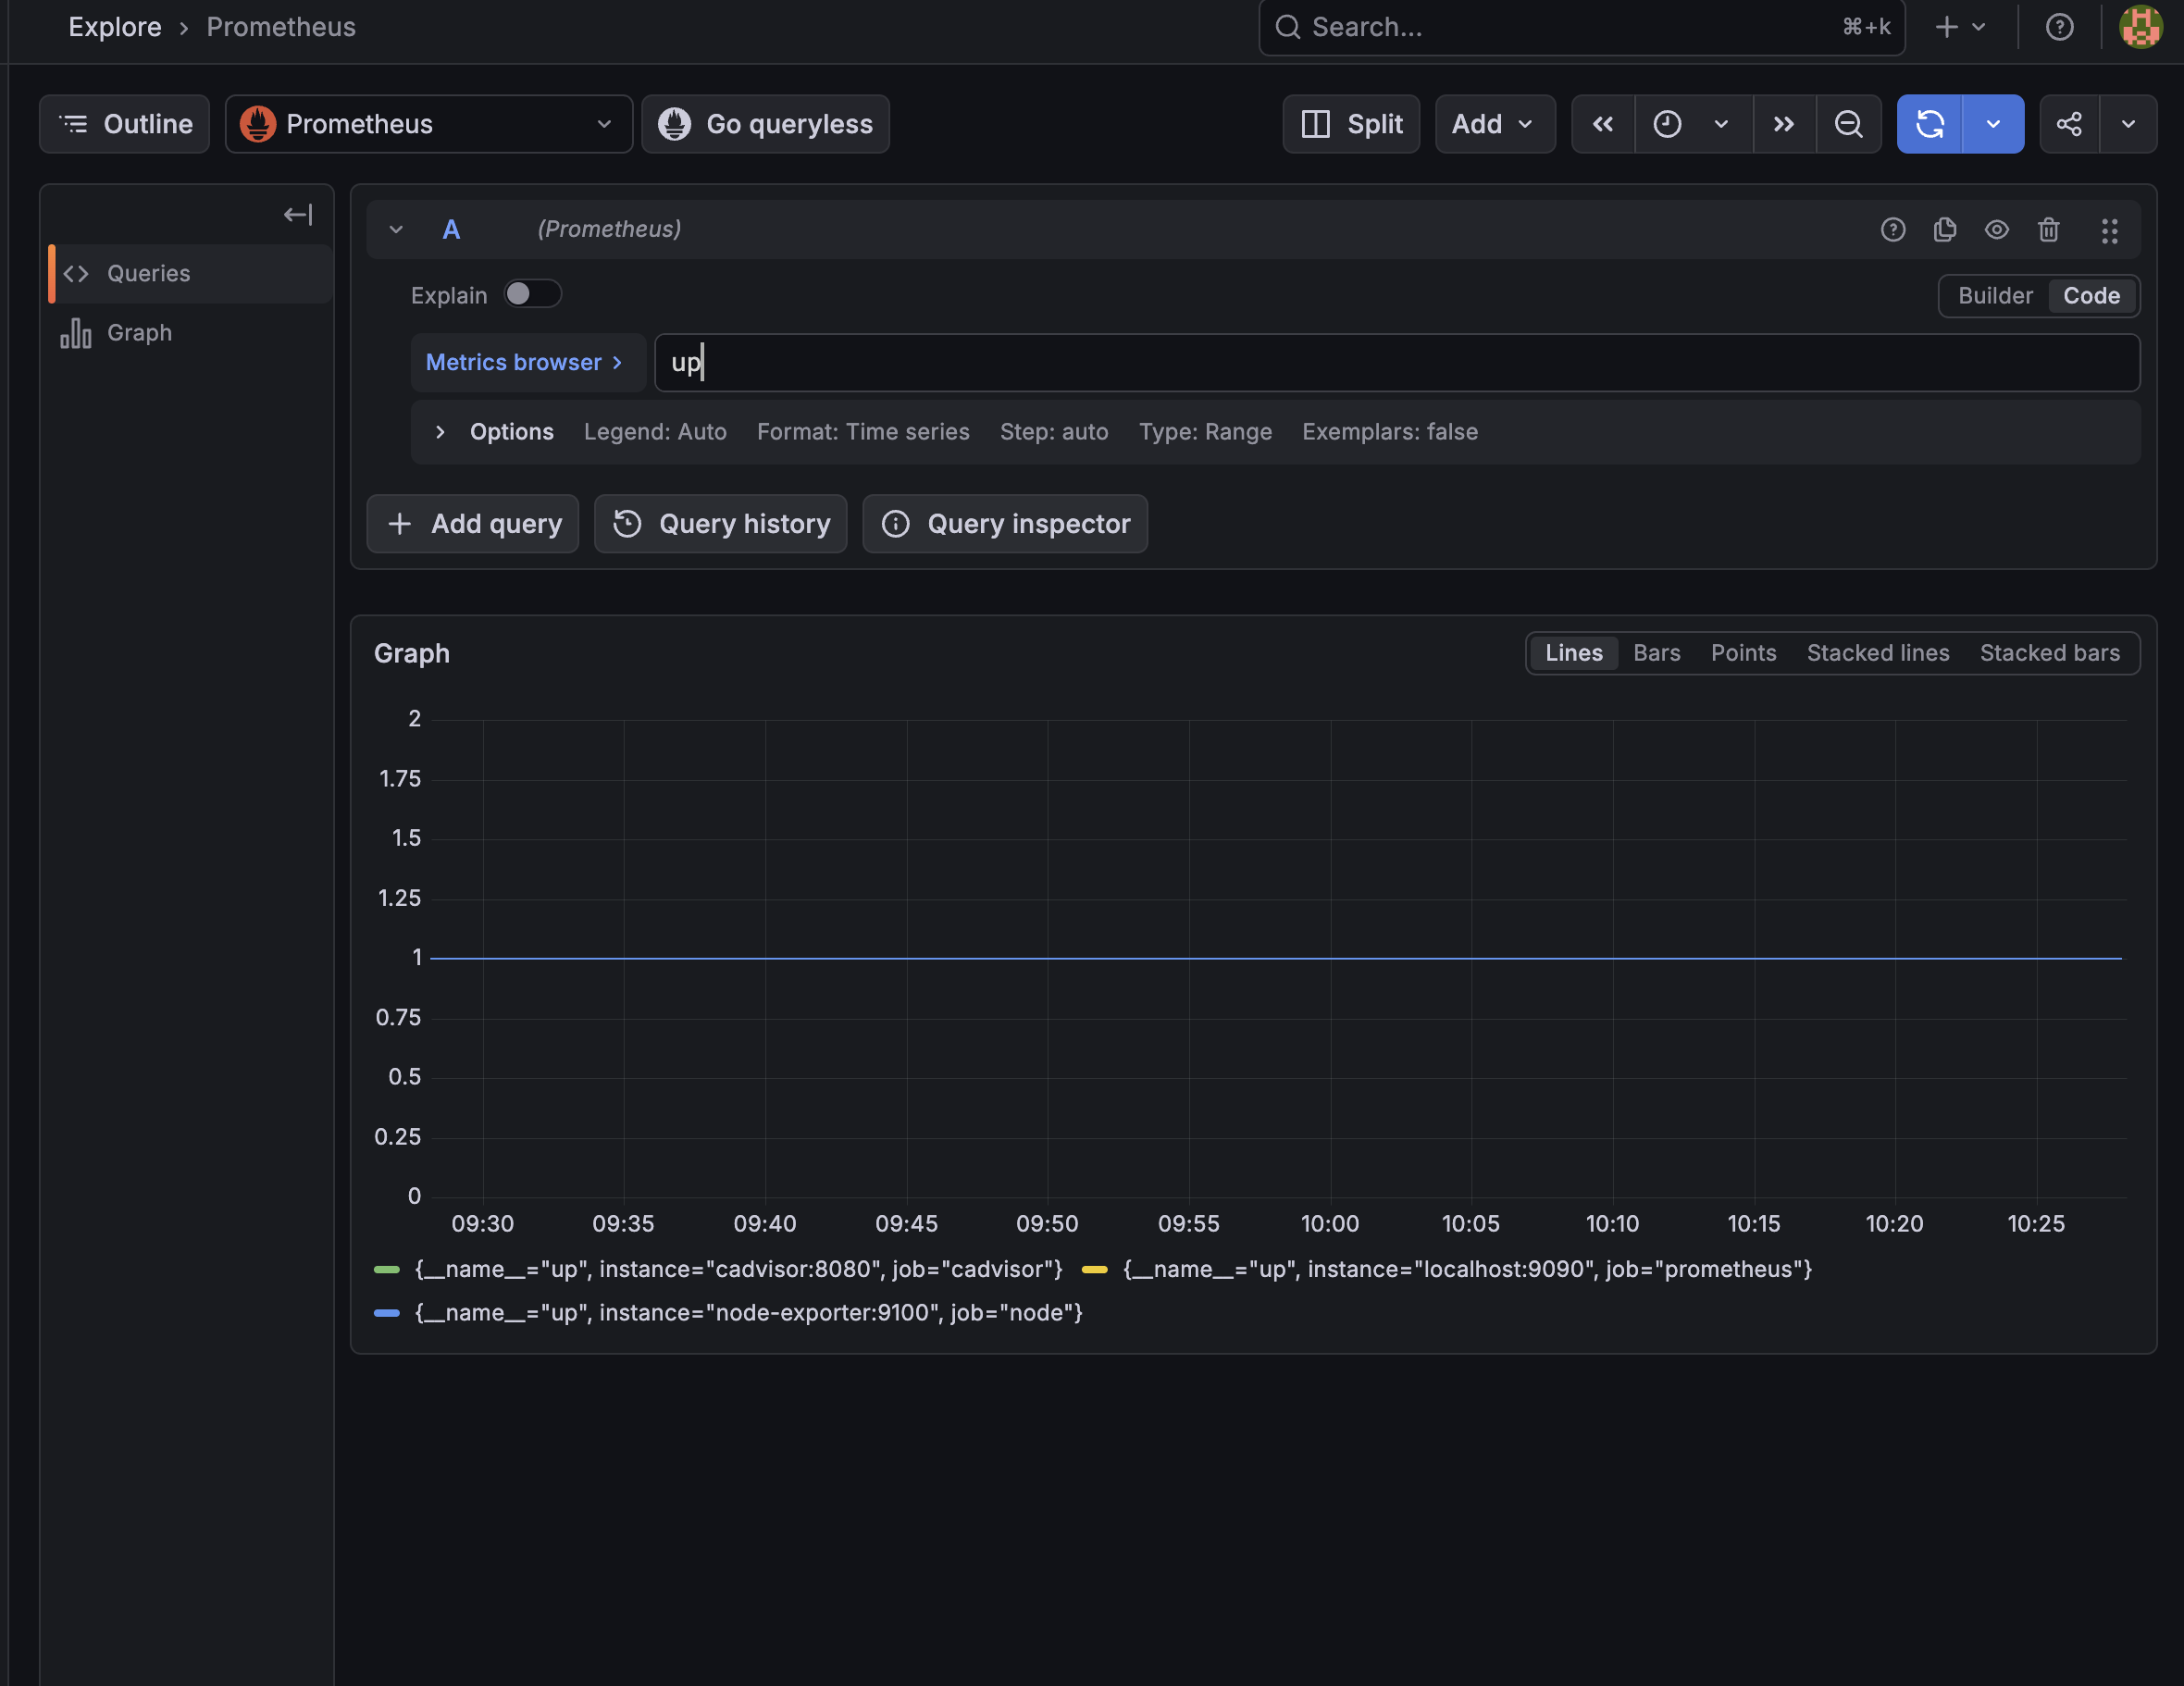
연결 검증 — 팀원 Grafana에 Prometheus datasource를 추가하고 up 쿼리로 타겟이 보이는지 확인. 두 VPC는 VPC 피어링으로 잇고, 접근은 IP가 아니라 크로스-VPC 보안그룹 참조(Grafana SG → mon SG의 9090)로 열었다.
보안그룹을 IP가 아니라 SG로 참조하면, 인스턴스가 바뀌어 IP가 변해도 규칙이 그대로 산다. 피어링이 돼 있으면 다른 VPC의 SG도 소스로 참조할 수 있다.
초기엔 mon 박스에도 Grafana를 함께 띄웠지만 팀원 Grafana와 중복이라 로컬 Grafana는 은퇴시켰다. 지금 mon 박스엔 Prometheus·Alertmanager + exporter만 남고, 보는 쪽(Grafana)은 팀원 관측 VPC로 일원화했다.
3. GPU 관측 — node/cAdvisor로는 부족하다
GPU 박스엔 node_exporter·cAdvisor만으론 GPU 사용량(VRAM·util·온도)이 안 잡힌다. 그건 DCGM-exporter(NVIDIA 전용)가 노출한다. 그래서 GPU 박스엔 셋을 다 띄우고 Prometheus에 gpu-node·gpu-cadvisor·gpu-dcgm job을 추가했다.
공식 DCGM 대시보드(12239)를 import해봤지만 변수·datasource가 안 맞아 No data가 떴다.
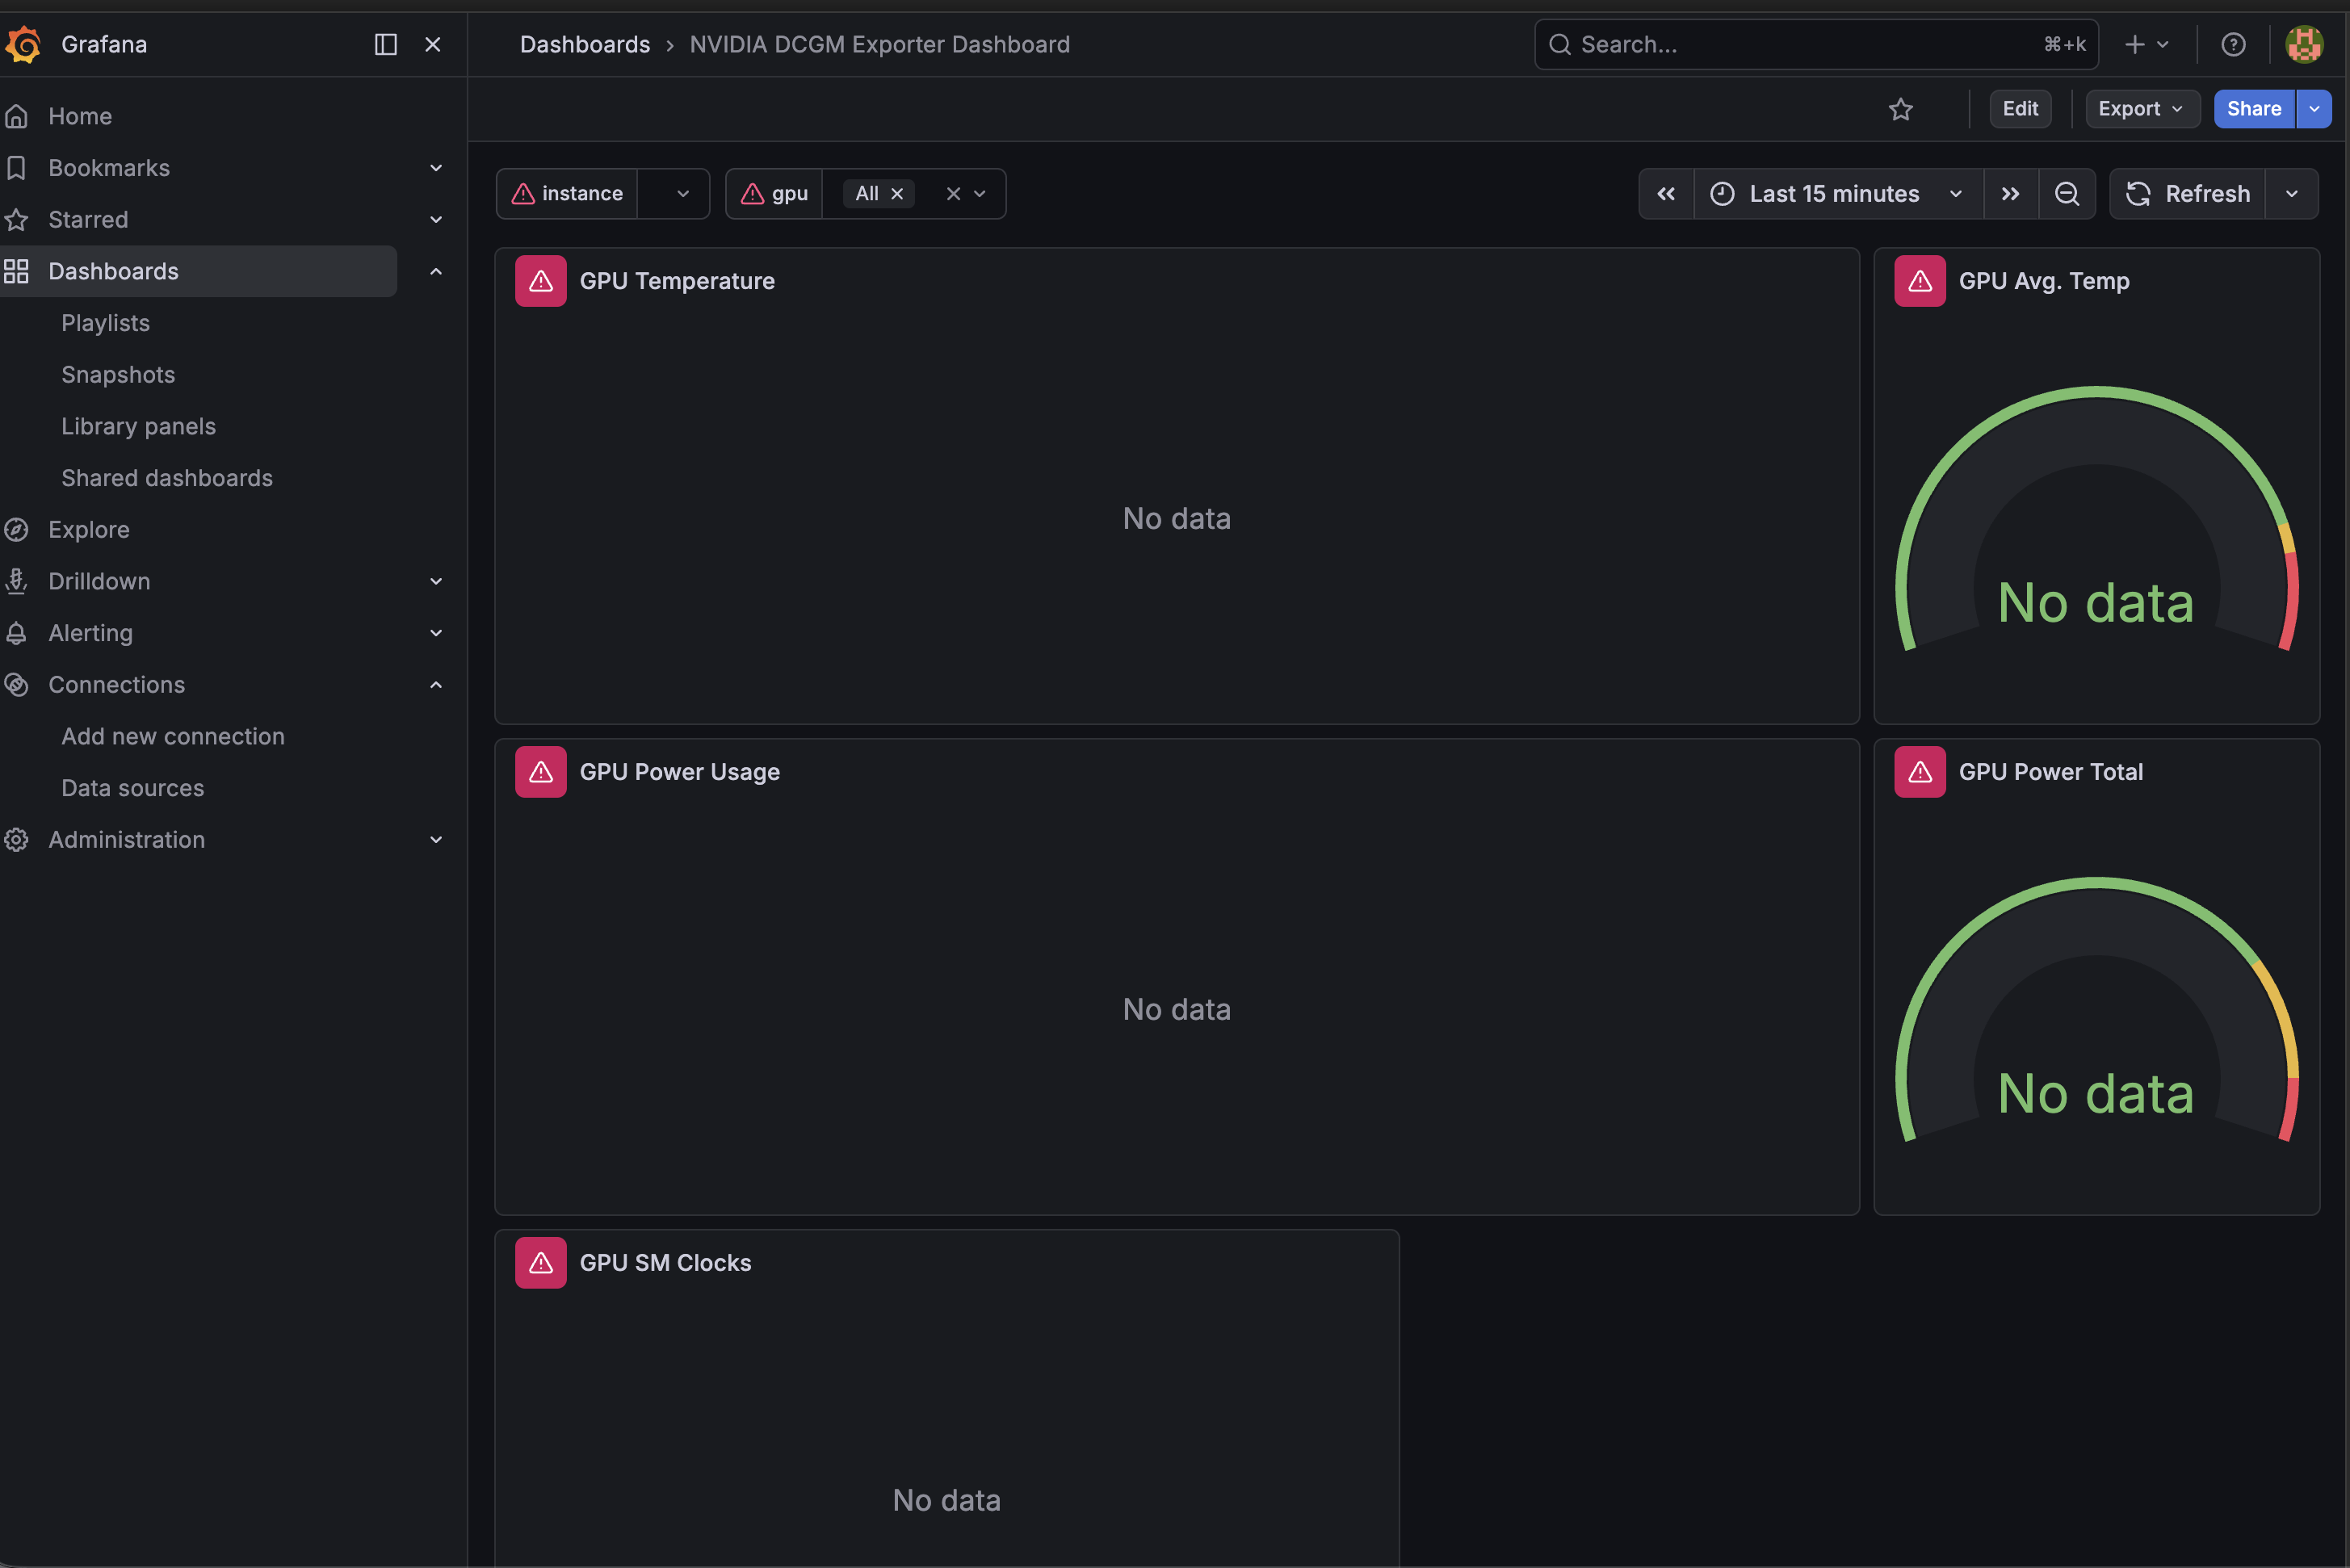
공식 대시보드 import 실패 (No data) — import한 대시보드의 변수 쿼리가 우리 라벨과 달라 빈 화면. → 포기하고 쿼리를 직접 쓴 커스텀 패널로 다시 만들었다.
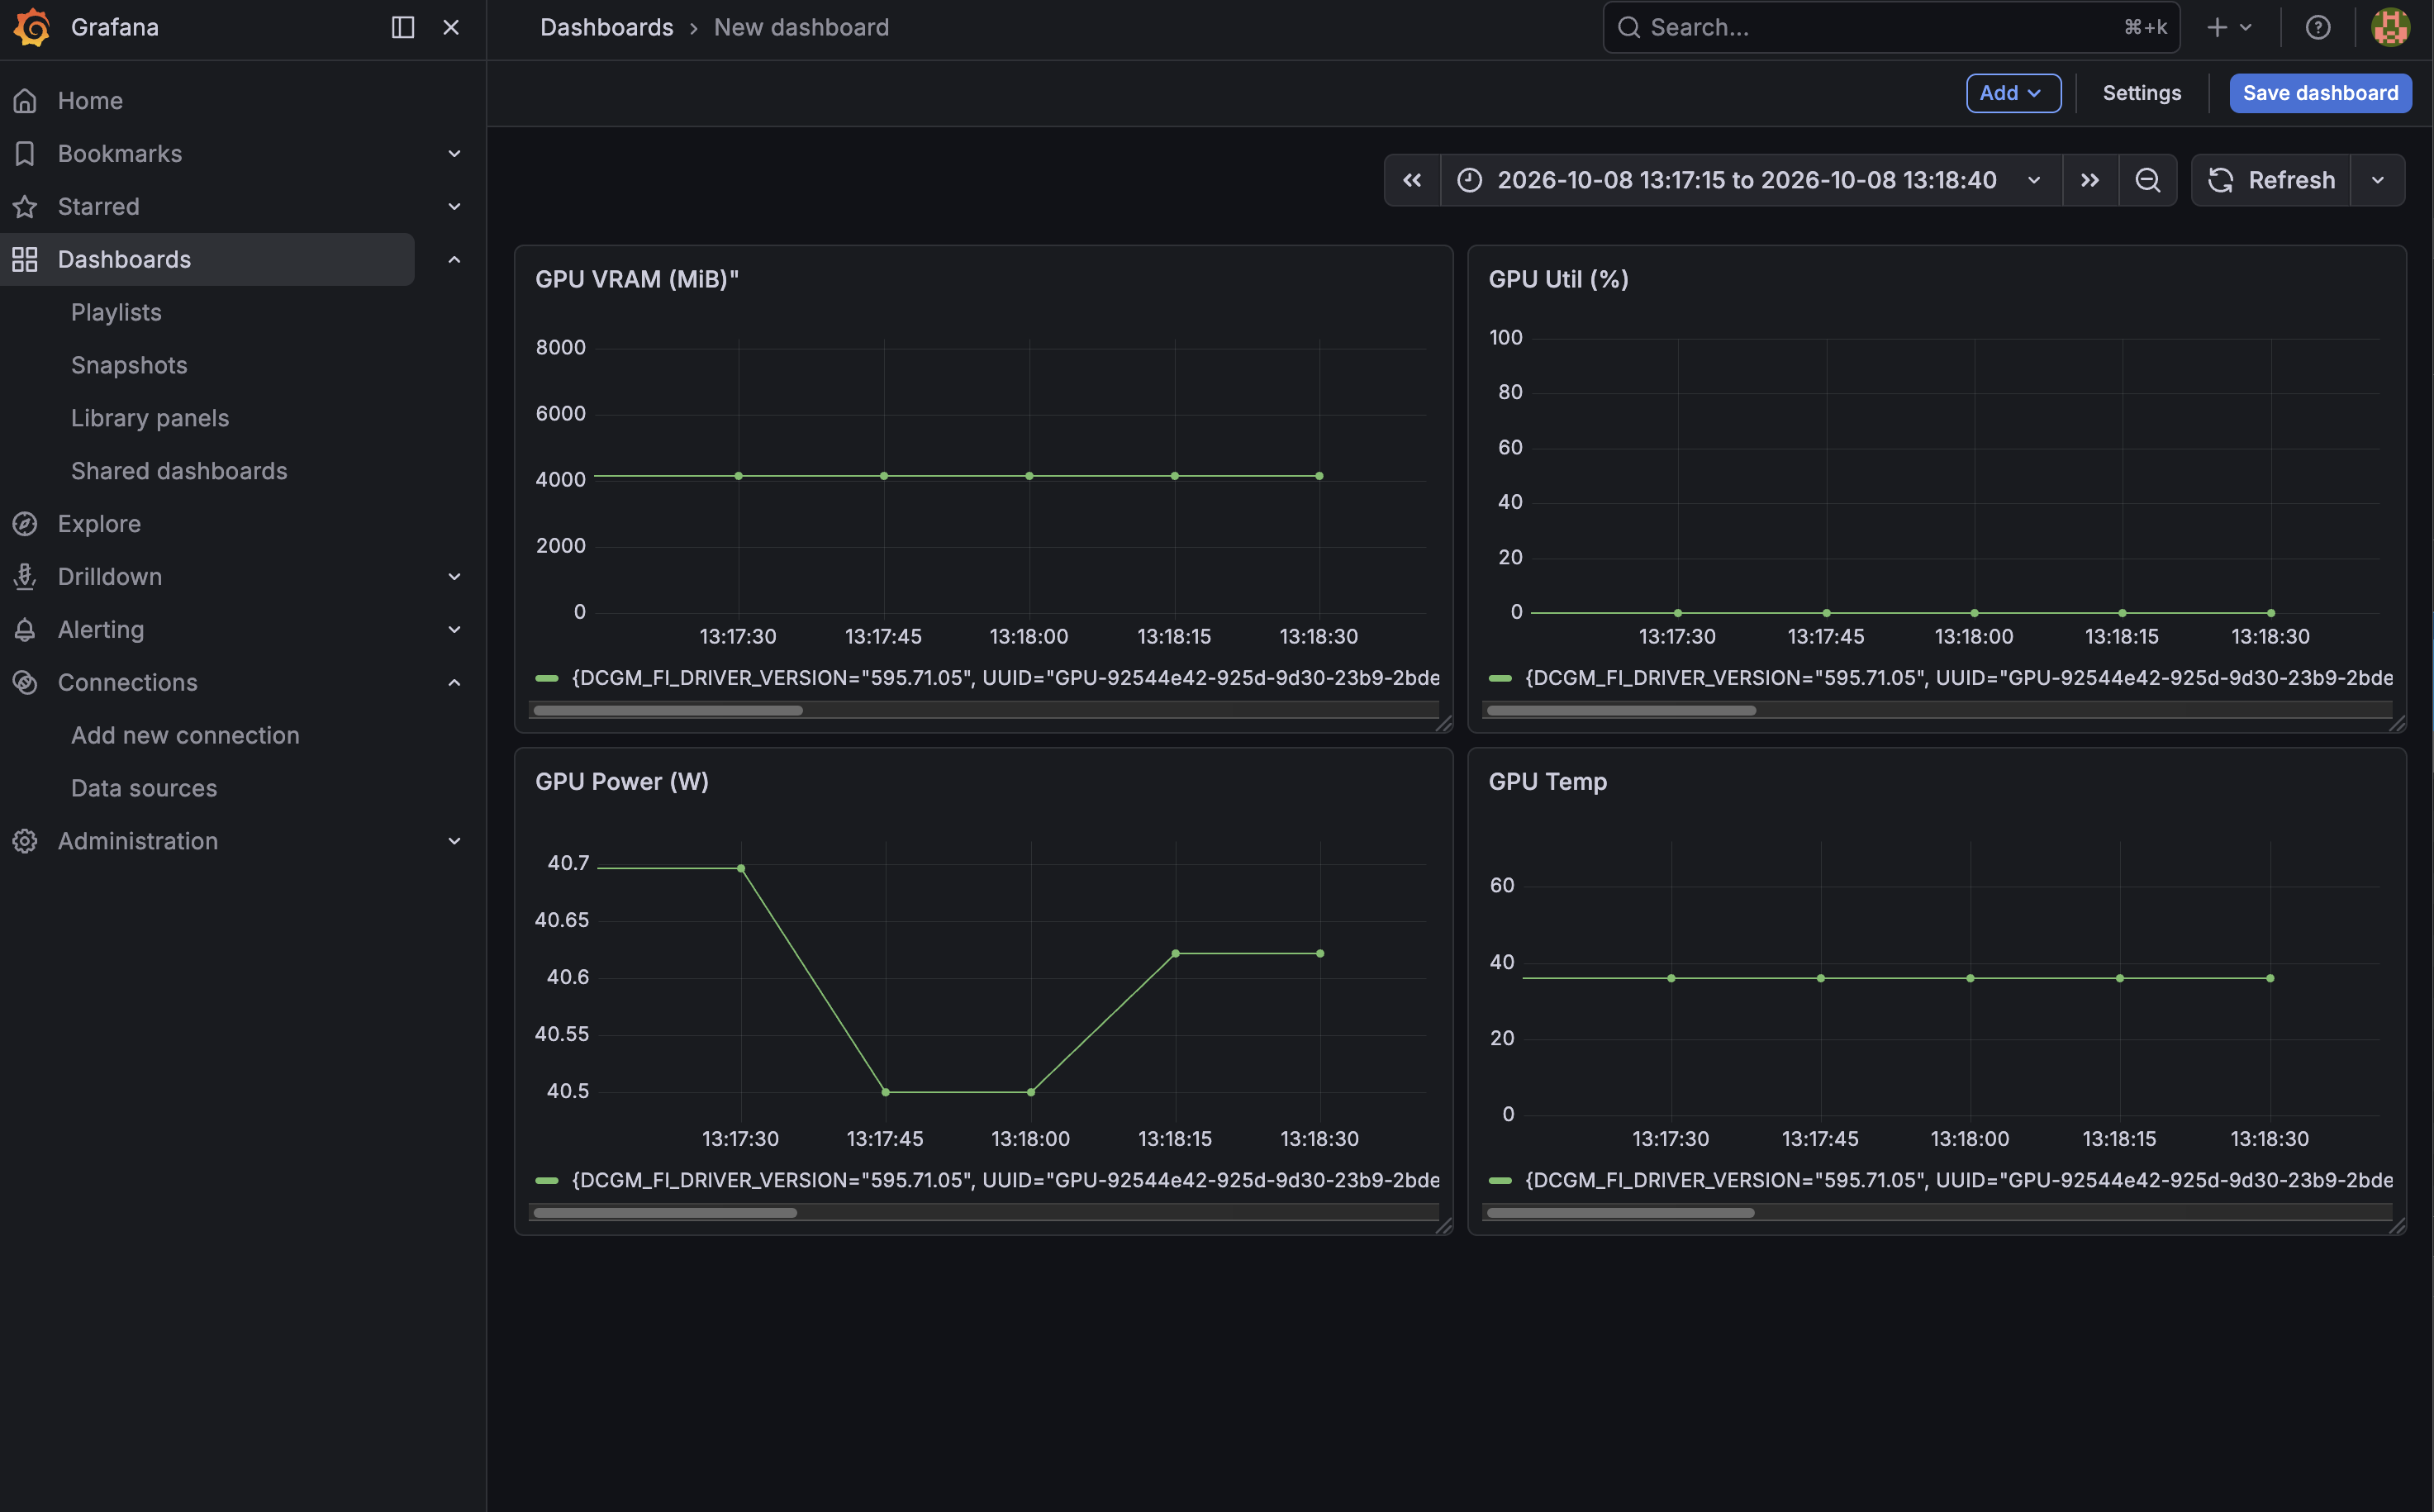
커스텀 GPU 대시보드 — DCGM_FI_DEV_FB_USED(VRAM)·util·power·temp를 직접 쿼리해 패널로. import보다 번거롭지만 확실히 뜬다.
컨테이너별로 쪼개 보고 싶으면 cAdvisor로 본다.
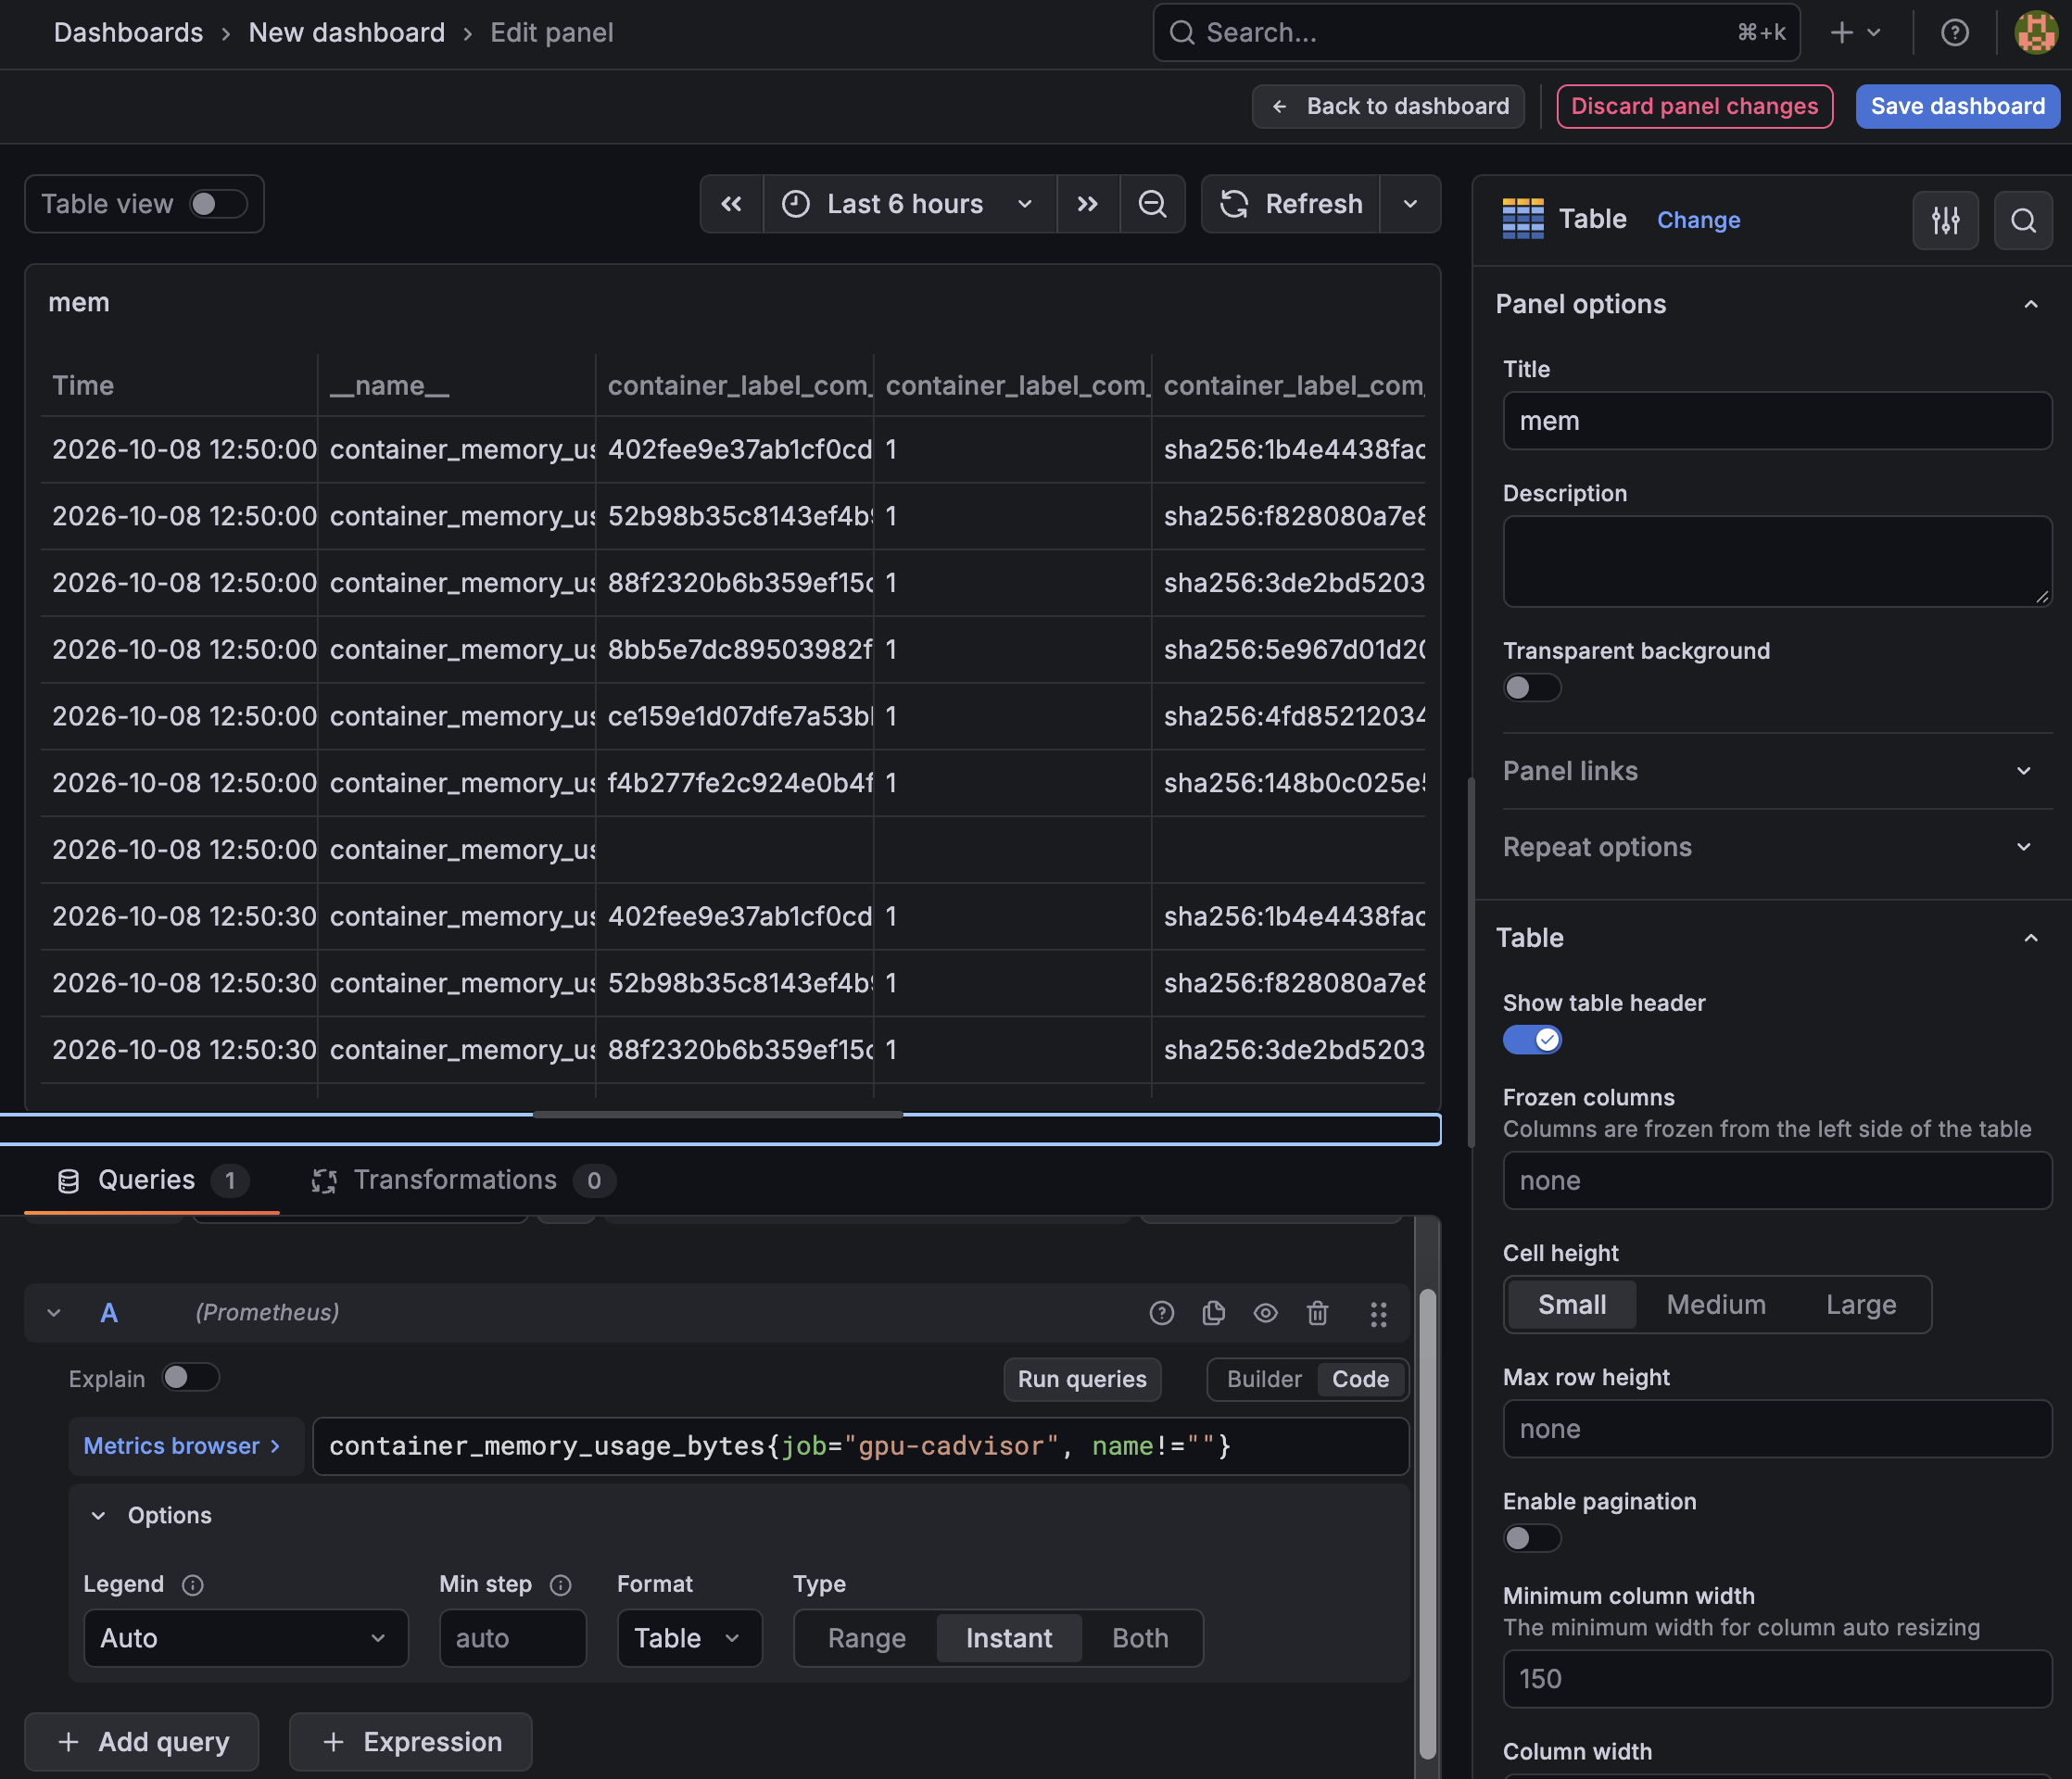
cAdvisor 컨테이너별 — container_memory_usage_bytes{name!=""}처럼 이름이 있는 모든 컨테이너를 매칭하면, 새 컨테이너가 떠도 자동으로 라인이 늘어난다(일일이 안 적어도 됨 — 이게 cAdvisor를 쓰는 이유).
4. Alertmanager → Slack + SSM 하드닝
InstanceDown(up == 0)·HighMemory 규칙을 만들고 발화를 검증했다.
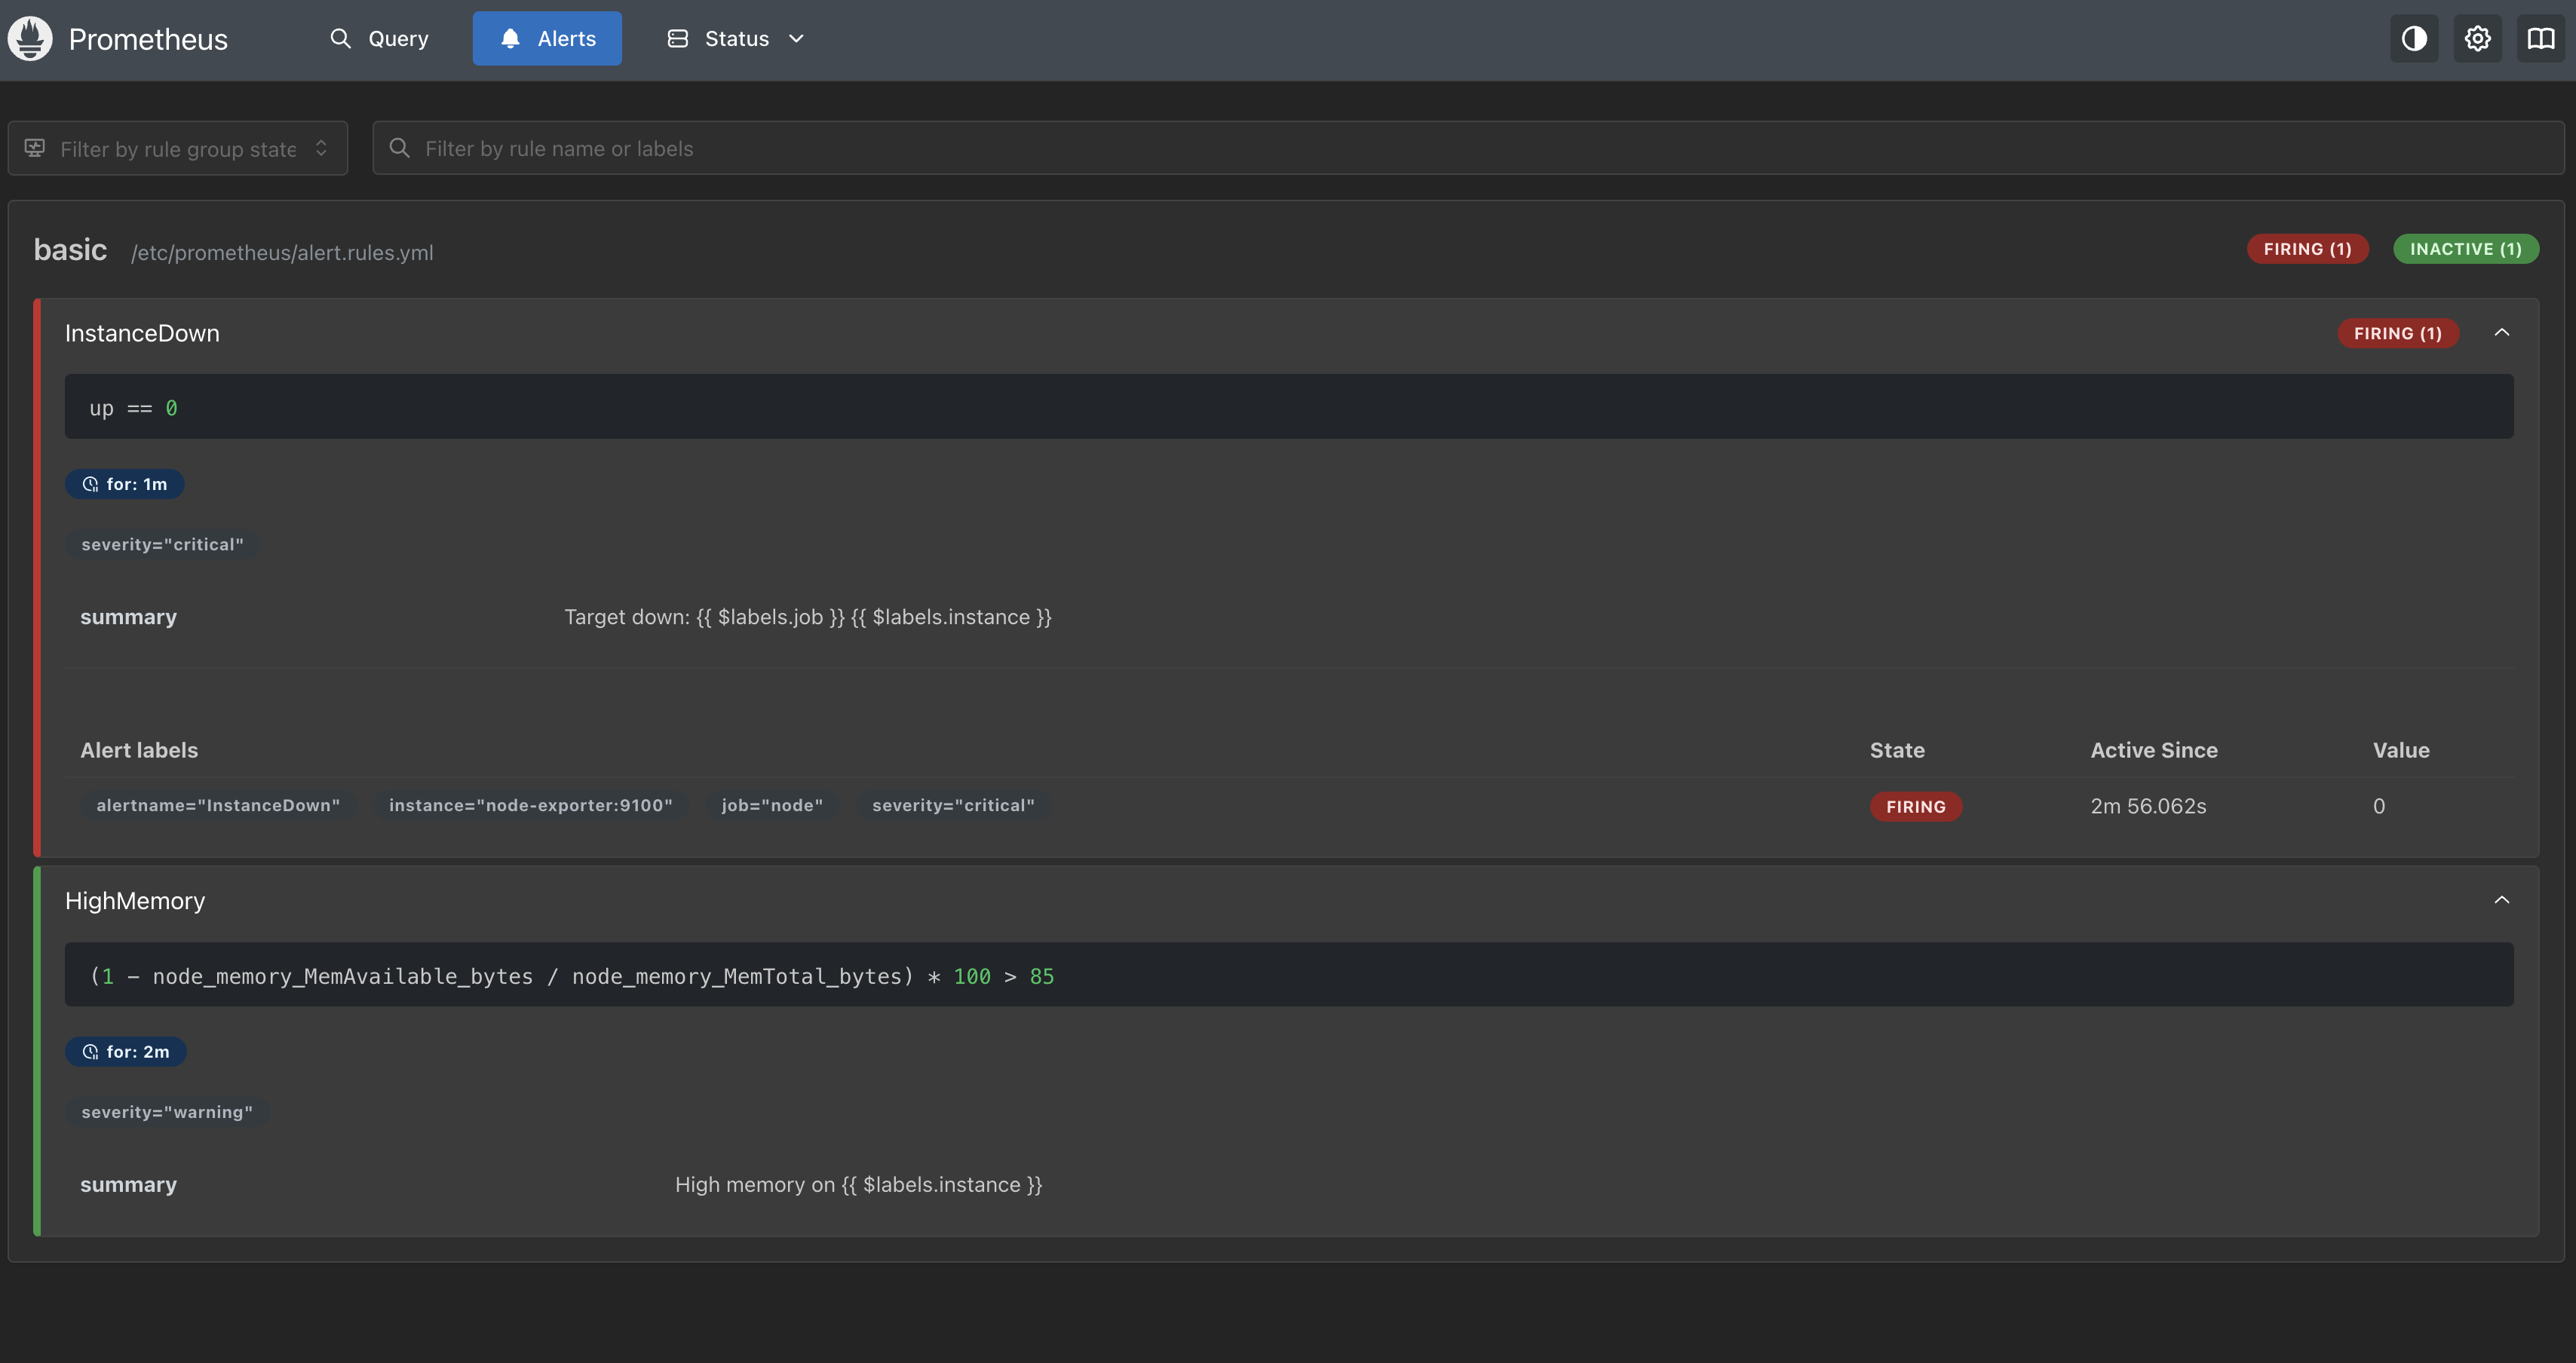
알럿 FIRING — 일부러 타겟을 내려 up == 0을 만들자 InstanceDown이 1분 뒤 FIRING. 이게 Alertmanager를 거쳐 Slack으로 간다.
막혔던 지점 둘:
- 앱 기반 Slack webhook은
channel오버라이드를 거부한다(404no_service). webhook이 채널을 고정하므로 설정에서channel:줄을 빼야 발송된다. - 같은
alertname은repeat_interval(4h) 전엔 재통지 안 함(dedup) — 테스트는 유니크한 alertname으로.
webhook URL은 비밀이라 설정/깃에 박지 않고 SSM Parameter Store(SecureString)에 넣고, 실행 때만 파일로 받아 쓴다(api_url_file). mon 박스 역할엔 그 파라미터만 읽는 최소 권한을 줬다.
1
2
3
4
5
6
7
8
9
{
  "Version": "2012-10-17",
  "Statement": [
    { "Effect": "Allow", "Action": "ssm:GetParameter",
      "Resource": "arn:aws:ssm:ap-northeast-2:<계정ID>:parameter/myton/qa/alertmanager/slack-webhook" },
    { "Effect": "Allow", "Action": "kms:Decrypt", "Resource": "*",
      "Condition": { "StringEquals": { "kms:ViaService": "ssm.ap-northeast-2.amazonaws.com" } } }
  ]
}
5. 백엔드 ASG 관측 — IP가 아니라 태그로 발견
백엔드는 Auto Scaling Group이라 인스턴스가 교체되며 IP가 계속 바뀐다. static IP로 긁을 수 없어서, Prometheus의 EC2 서비스 디스커버리(ec2_sd)로 태그(Name=myton-qa-backend-asg)를 보고 자동 발견하게 했다. exporter는 Launch Template의 user-data에 구워, ASG가 새로 띄우는 인스턴스마다 부팅 시 자동으로 올라온다.
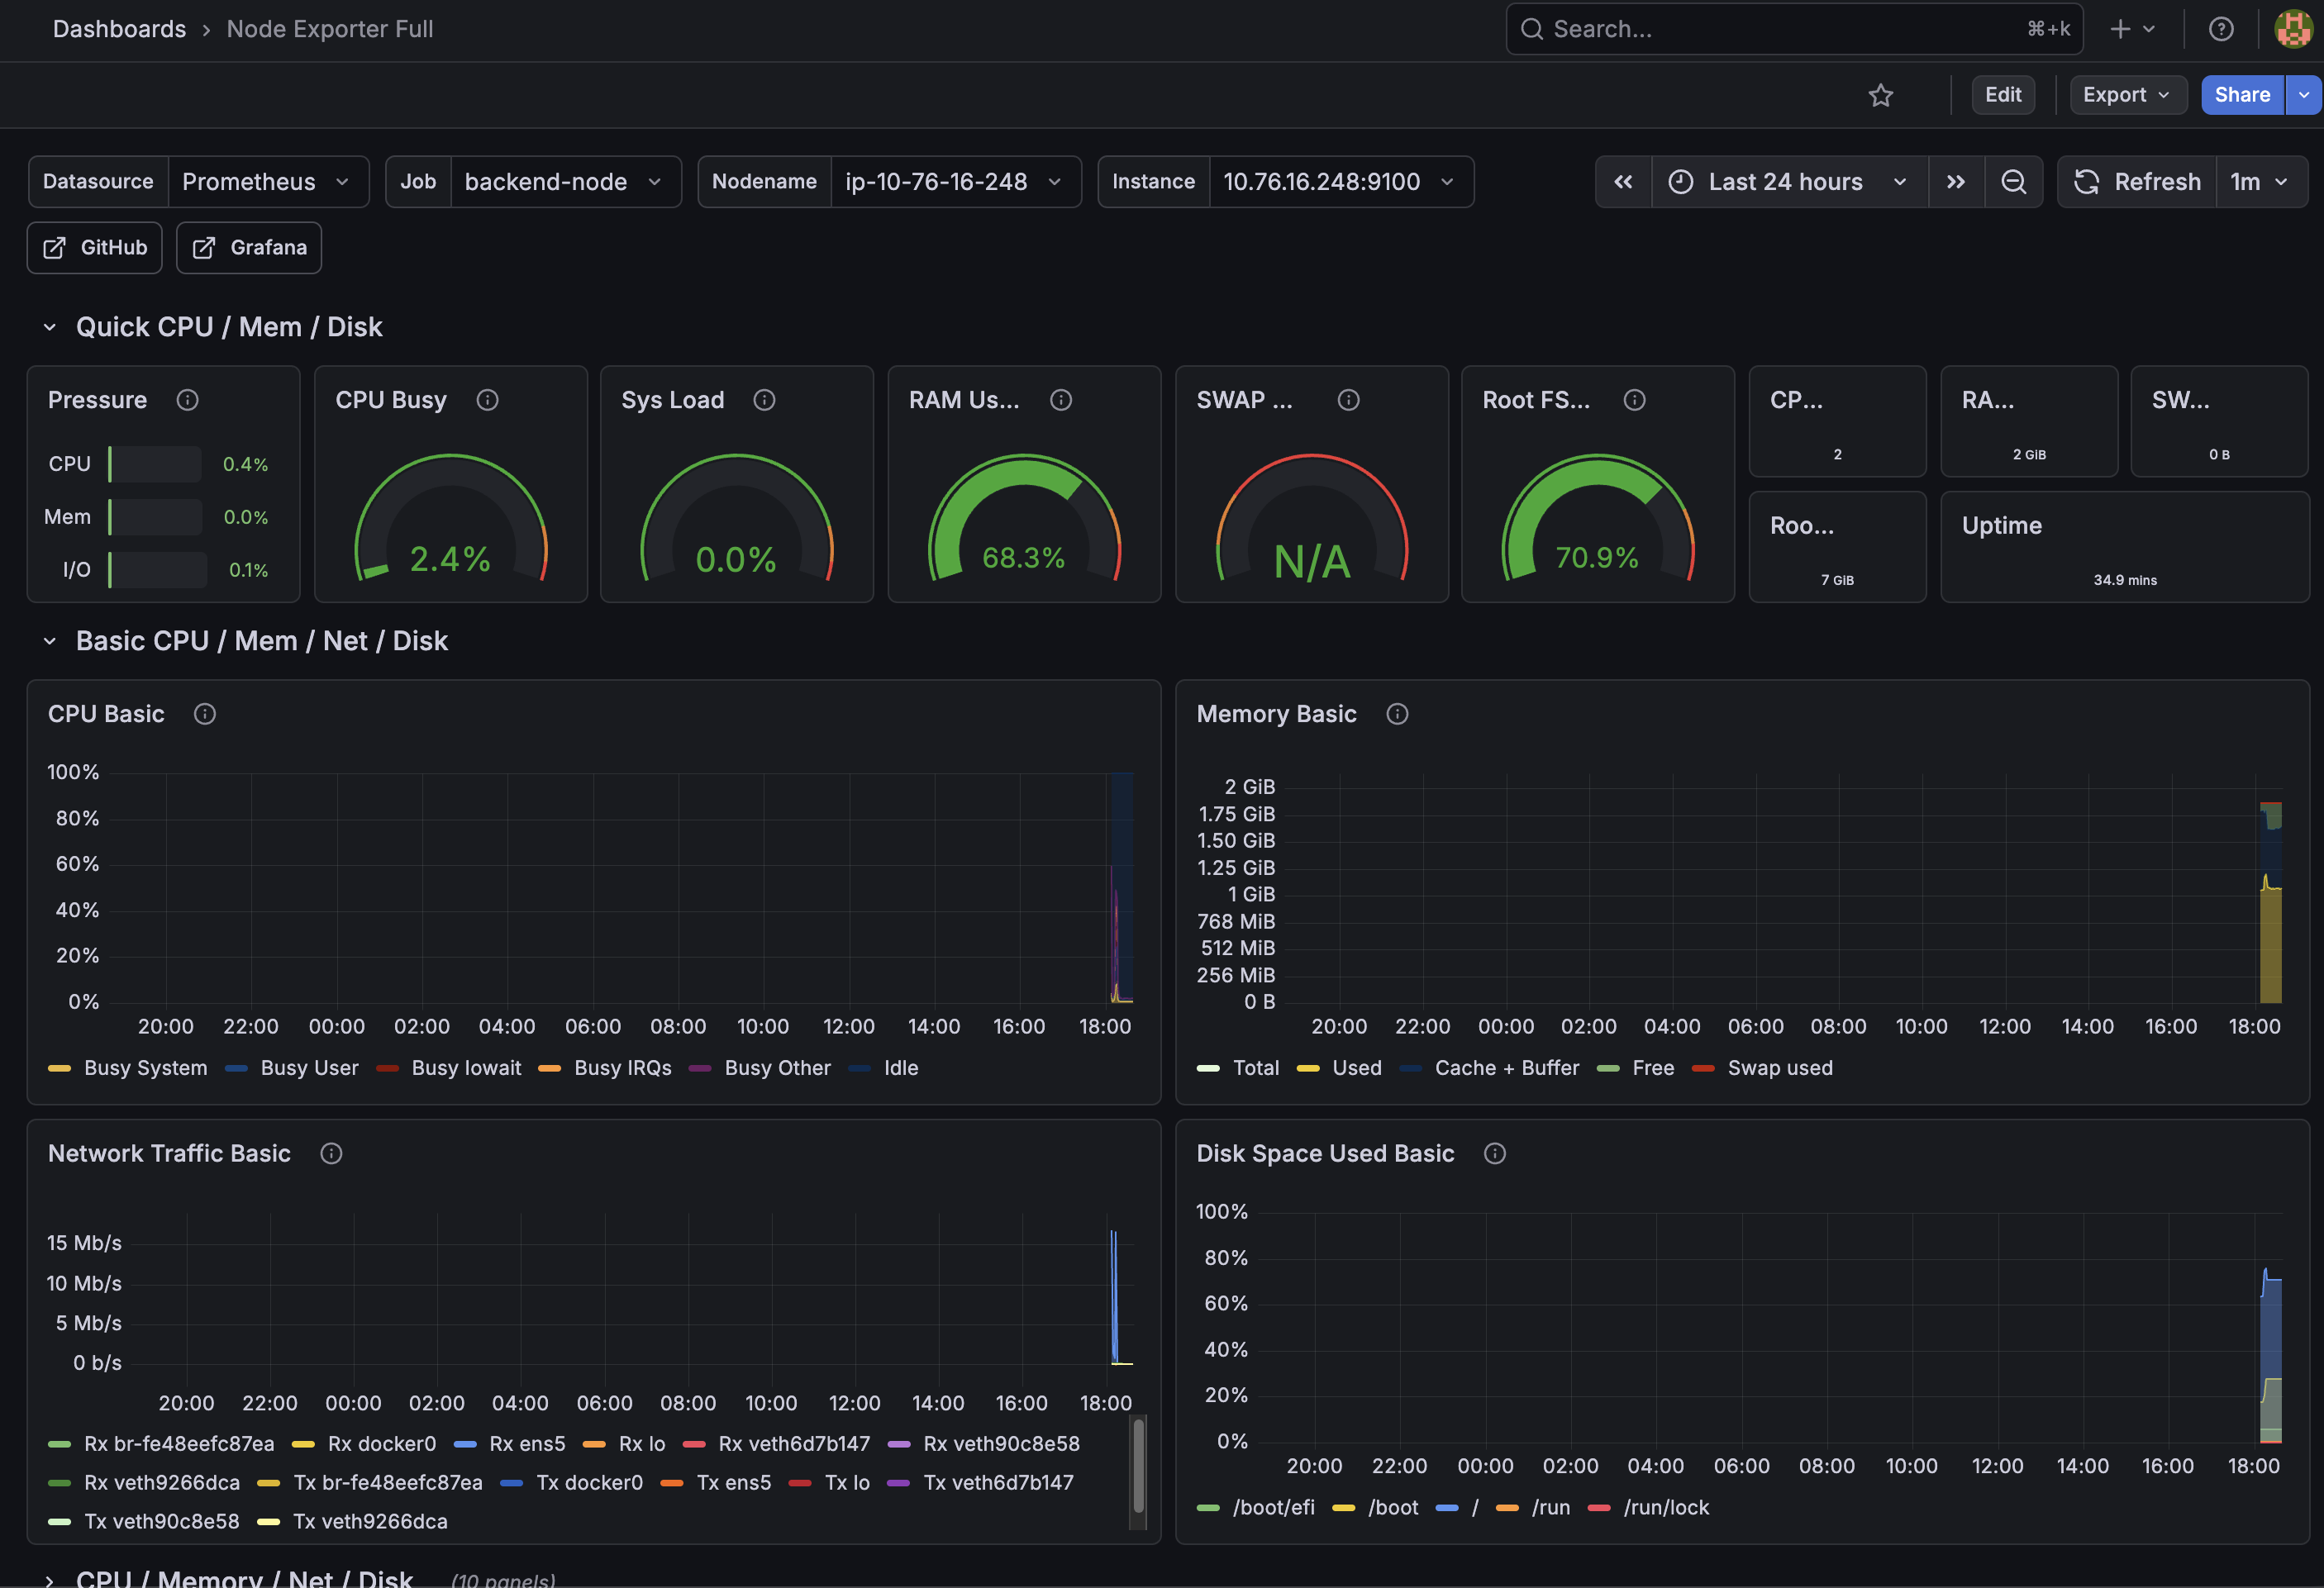
백엔드 노드가 1860에 뜬 모습 — 인스턴스를 교체(IP가 ...118 → ...248로 변경)했는데도 ec2_sd가 새 인스턴스를 태그로 재발견해 타겟이 끊기지 않았다. static이었다면 교체마다 수동으로 고쳐야 했을 것.
겪은 삽질에서 배운 것
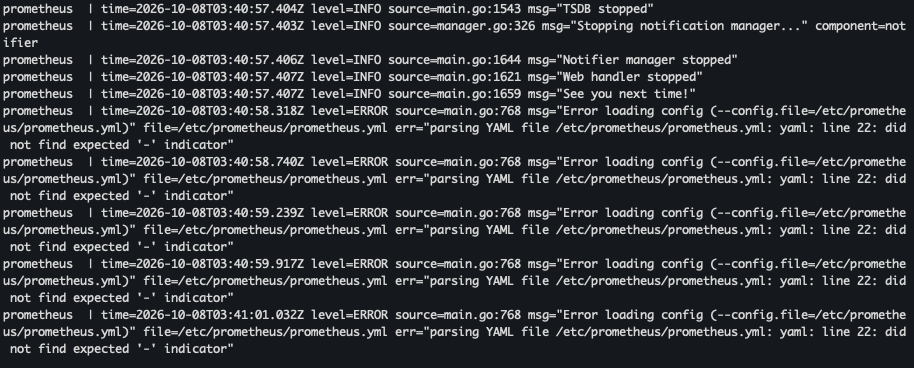
prometheus.yml 들여쓰기 1칸 → crash — yaml: line 22: did not find expected '-' indicator로 컨테이너가 재시작 루프. YAML은 들여쓰기가 문법이라 공백 하나에도 깨진다(bash는 안 그런데). 로그가 정확히 line 22를 짚어줘서 빨리 잡았다. → 이후론 reload 전에 promtool check config로 먼저 검증하는 습관.
남은 것 / 다음
- GPU가 RunPod로 이전하면, 지금의 SG+static 배선 대신 remote_write(pod가 push)로 재구성
각 조각(① 풀 스택 ② obs 연결 ③ GPU ④ Alert ⑤ 백엔드)의 개념과 디버깅은 이어지는 글에서 하나씩 자세히 다룬다.