GPU는 cAdvisor에 안 잡힌다 — DCGM exporter와 공식 대시보드 삽질기
node_exporter와 cAdvisor를 다 붙였는데 GPU 사용량이 하나도 안 보였다. GPU는 그 둘이 못 보고 제3의 exporter(DCGM)가 따로 잰다. 거기에 공식 GPU 대시보드를 import했더니 전부 No data — 그 삽질과 해결 기록.
이 글은 QA 관측 스택 구축기의 ③ GPU 관측 조각을 자세히 푼 것이다. 계정 번호 자리는 <계정ID>로 적는다.
node_exporter·cAdvisor는 GPU를 못 본다
처음엔 “cAdvisor가 컨테이너를 보니 GPU도 거기 있겠지” 했는데, cAdvisor를 열어봐도 GPU는 없다. 이유는 둘이 읽는 곳에 GPU 정보가 없어서다.
- node_exporter는
/proc(커널)을 읽는다 → 거기엔 쓸만한 GPU 정보가 없다 - cAdvisor는 cgroups/docker를 읽는다 → CPU·메모리는 있지만 GPU는 안 본다
- GPU 상태는 NVIDIA 드라이버/NVML 계층에 있고, 그걸 읽는 게 DCGM exporter다
flowchart TB
    Q["GPU 사용률·VRAM·온도를 보려면?"]
    Q --> NE["node_exporter ❌<br/>/proc엔 쓸만한 GPU 정보 없음"]
    Q --> CA["cAdvisor ❌<br/>cgroups=CPU·메모리, GPU 안 봄"]
    Q --> DC["DCGM exporter ✓ (NVIDIA)<br/>util · VRAM(FB) · 온도 · 전력"]
즉 GPU는 cAdvisor에 숨어있는 게 아니라, GPU 박스에 DCGM을 따로 깔고 Prometheus 타겟으로 추가해야 비로소 보인다. 안 깔면 GPU는 수집 자체가 안 된다.
DCGM = 물리 GPU “전체” 계기판
중요한 한계부터. DCGM은 물리 GPU 하나를 읽어 전체 숫자(총 util, 총 VRAM)를 준다. 컨테이너 경계를 모르니 모델별로는 안 쪼개진다.
flowchart TB
    subgraph BOX["GPU 박스 (물리 GPU 1개 = T4 16GB)"]
        C1["컨테이너A (모델1)"]
        C2["컨테이너B (모델2)"]
        C3["컨테이너C (모델3)"]
        GPU["물리 GPU"]
        C1 --> GPU
        C2 --> GPU
        C3 --> GPU
    end
    GPU --> DCGM["dcgm-exporter (박스 1개)<br/>물리 GPU를 읽음"]
    DCGM --> M["총 util · 총 VRAM(/16GB)<br/>= 3모델 합계만 (누가 얼마인지는 X)"]
우리 GPU 박스는 모델 여러 개가 T4 1장(16GB)을 공유한다. 이 구성에선 “지금 VRAM이 16GB 중 얼마나 찼나”가 제일 중요한 지표라, 전체만 보는 DCGM으로도 1순위 니즈는 충족된다. (모델별로 쪼개는 법은 맨 아래에서 다룬다)
설치 + 배선
GPU 박스의 docker compose에 DCGM exporter를 추가했다. GPU에 접근해야 하므로 일반 컨테이너와 다른 옵션이 붙는다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
  dcgm-exporter:
    image: nvcr.io/nvidia/k8s/dcgm-exporter:latest
    container_name: dcgm-exporter
    restart: unless-stopped
    cap_add: [SYS_ADMIN]          # DCGM이 GPU 계측에 필요로 하는 권한
    ports:
      - "9400:9400"
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia       # 이 컨테이너에 NVIDIA GPU를 할당
              count: all
              capabilities: [gpu]
그다음 GPU 박스 보안그룹에 mon 박스가 긁을 수 있게 인바운드를 열었다 — 9100(node)·8080(cadvisor)·9400(dcgm)을 mon SG에서 오는 것만 허용(IP가 아니라 SG 참조).
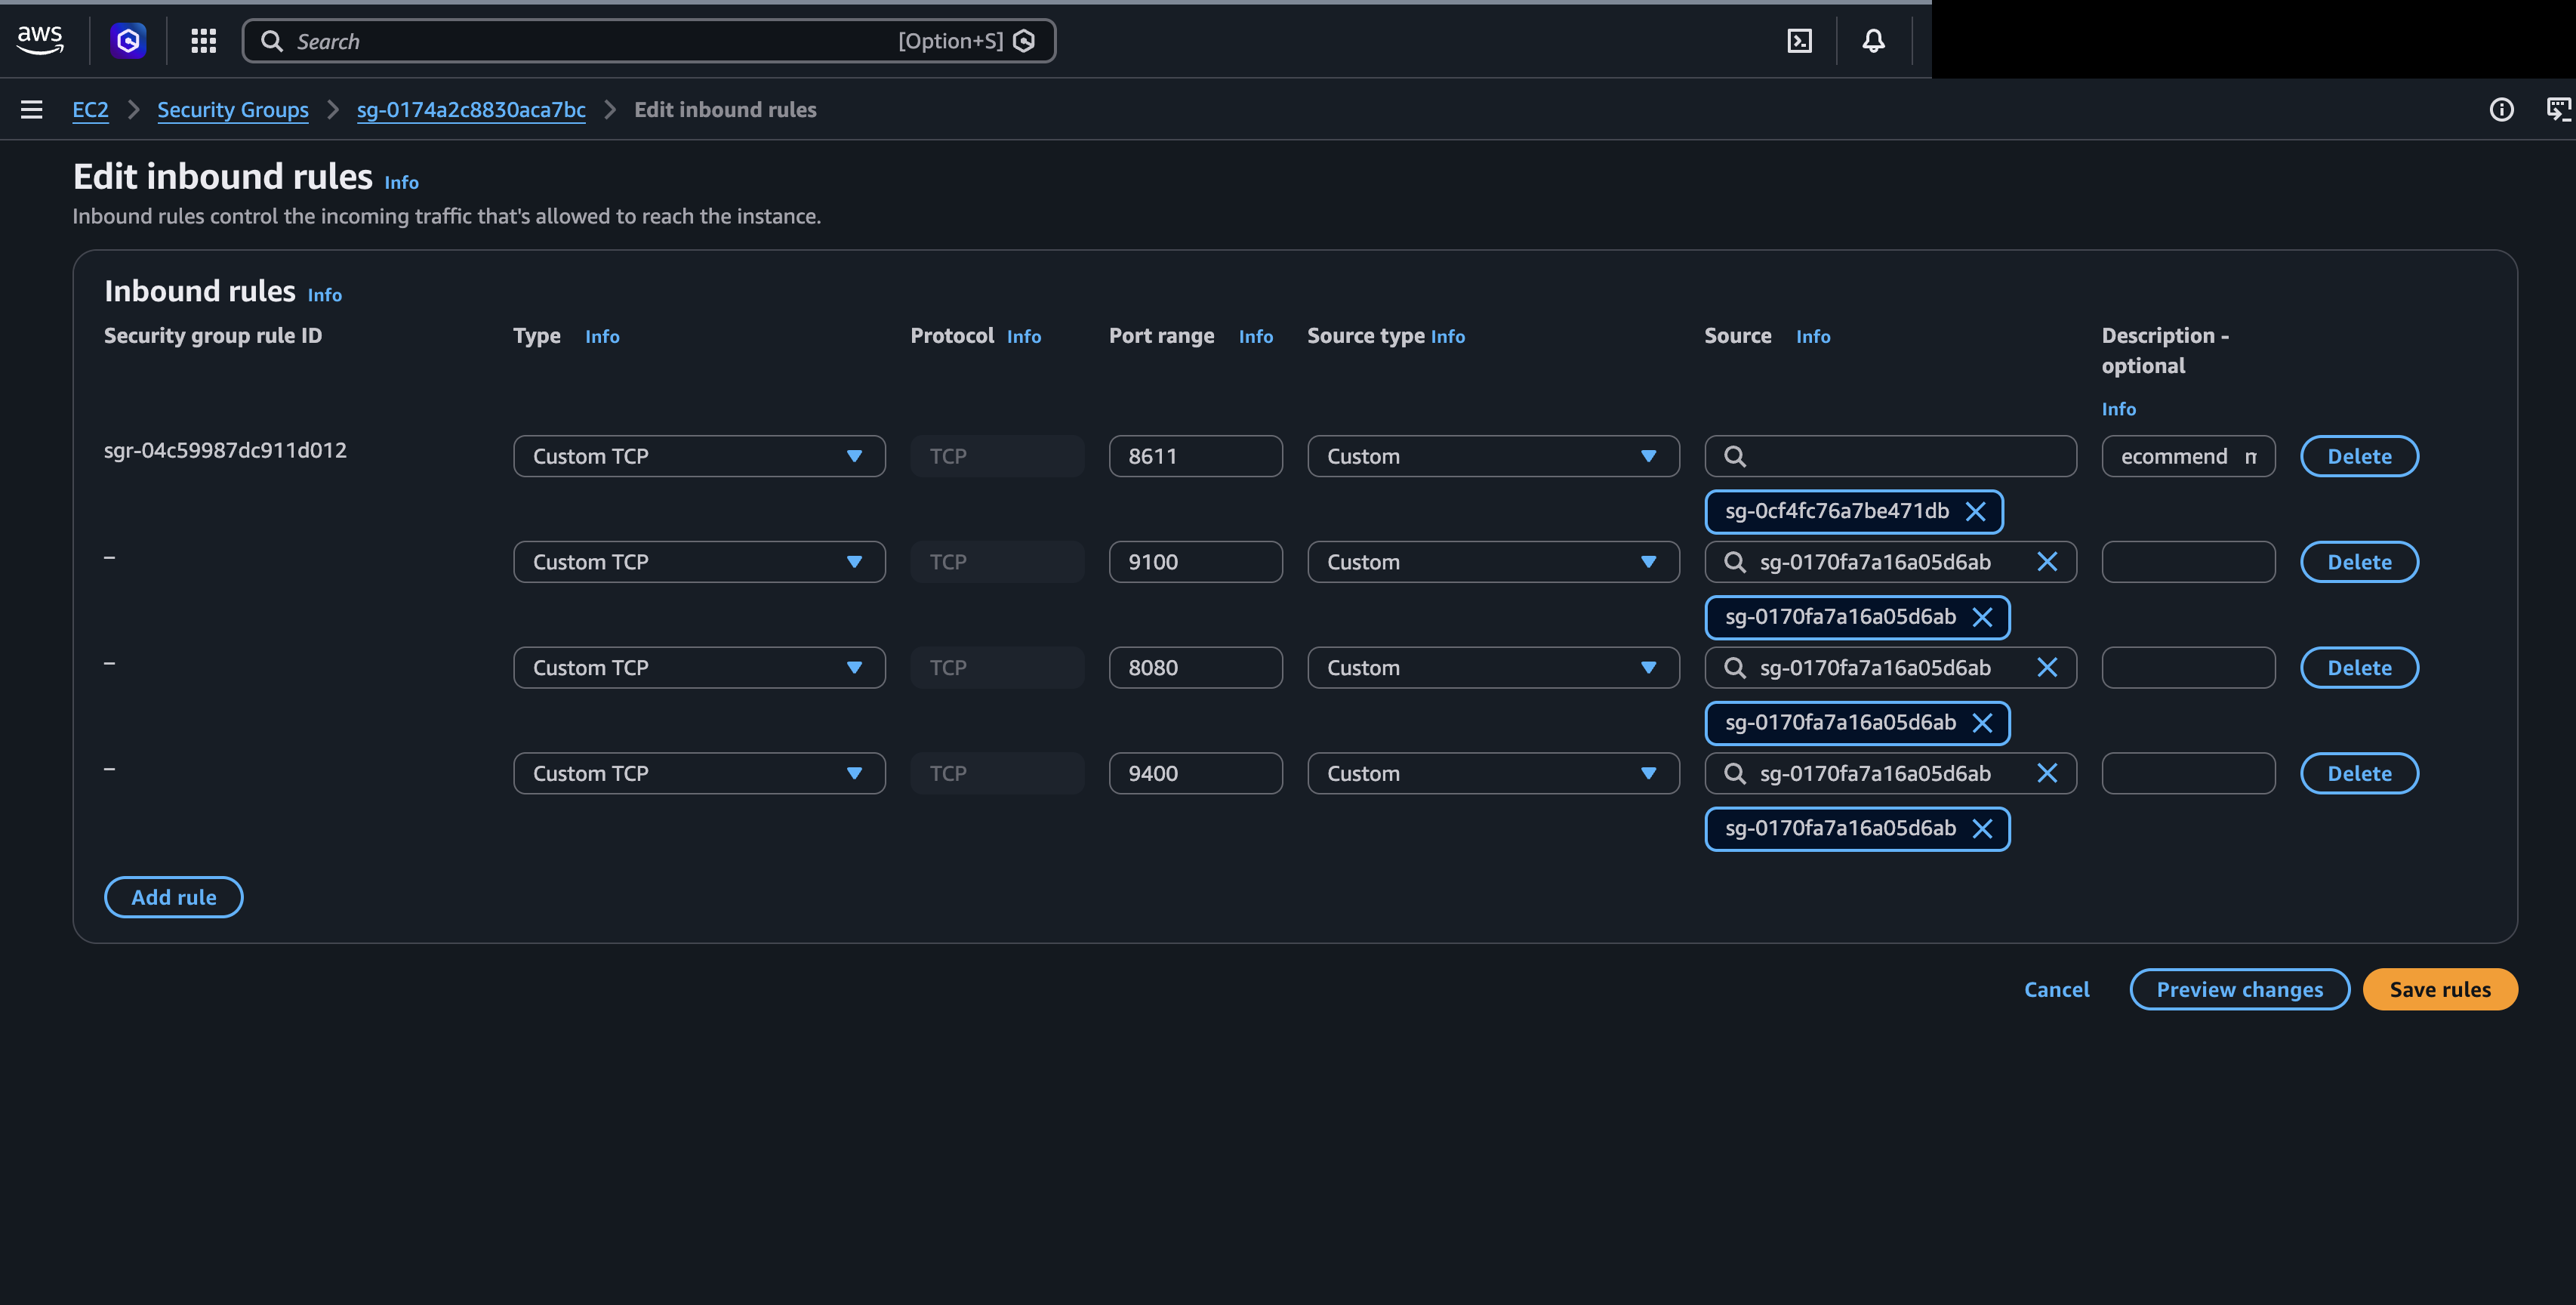
GPU SG 인바운드 — 9100·8080·9400을 모두 sg-0170...(mon SG)에서만. (우상단 계정 정보는 가림)
마지막으로 mon 박스 prometheus.yml에 job 3개를 추가했다. GPU는 단일 고정 박스라 IP를 그대로 적었다(백엔드 ASG처럼 IP가 바뀌지 않아 ec2_sd가 필요 없다).
1
2
3
4
5
6
7
8
9
  - job_name: gpu-node
    static_configs:
      - targets: ['10.76.16.28:9100']
  - job_name: gpu-cadvisor
    static_configs:
      - targets: ['10.76.16.28:8080']
  - job_name: gpu-dcgm
    static_configs:
      - targets: ['10.76.16.28:9400']
job라벨(“gpu-dcgm” 같은 이름)은 exporter가 아니라 Prometheus가 scrape할 때 찍는다. exporter는 자기가 무슨 job인지 모른다. 그래서 “node냐 cadvisor냐 dcgm이냐”를 나중에 Grafana에서 가르는 기준이 이job라벨이다.
공식 대시보드 삽질 → 커스텀으로
GPU 타겟이 UP 되고 나서, Grafana에 공식 NVIDIA DCGM 대시보드(12239)를 import했다. 그런데 —
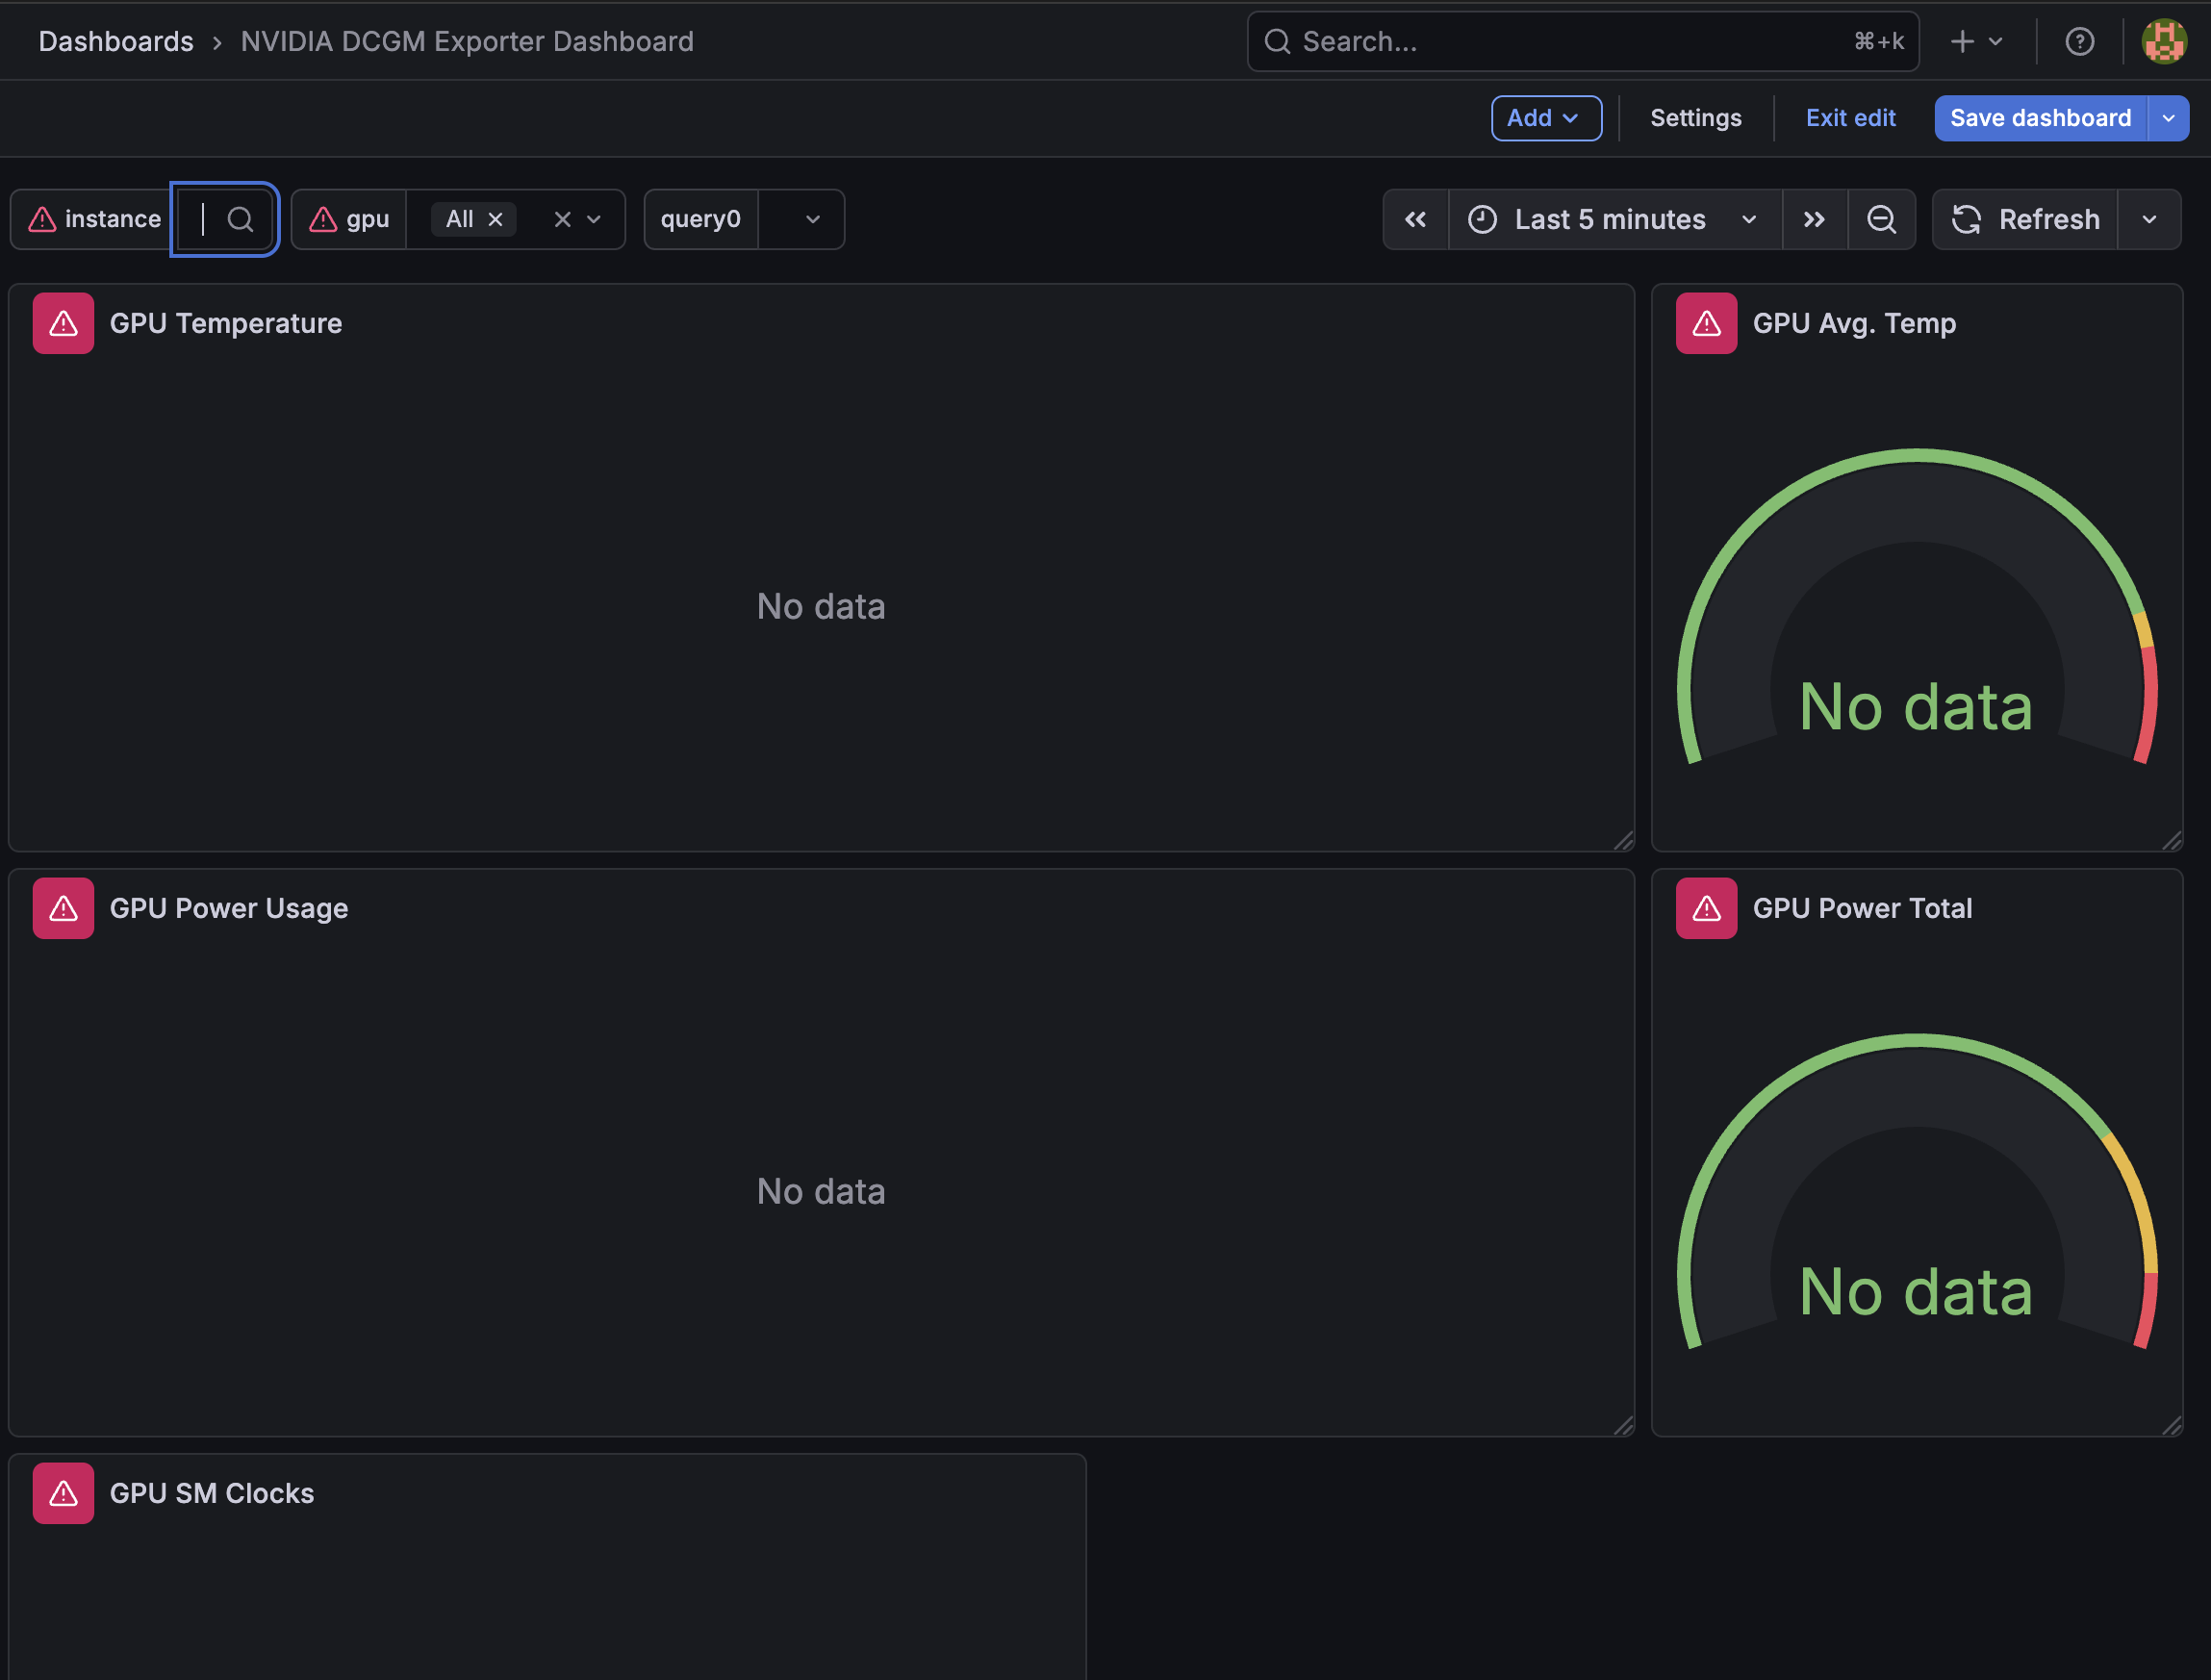
전 패널 No data — GPU Temperature·Power·SM Clocks 전부 “No data”. 상단 instance·gpu 변수에 ⚠️ 경고까지 떠 있다(변수 쿼리가 값을 못 찾음).
데이터가 아예 없는 걸까? Explore에서 직접 쿼리해봤다.
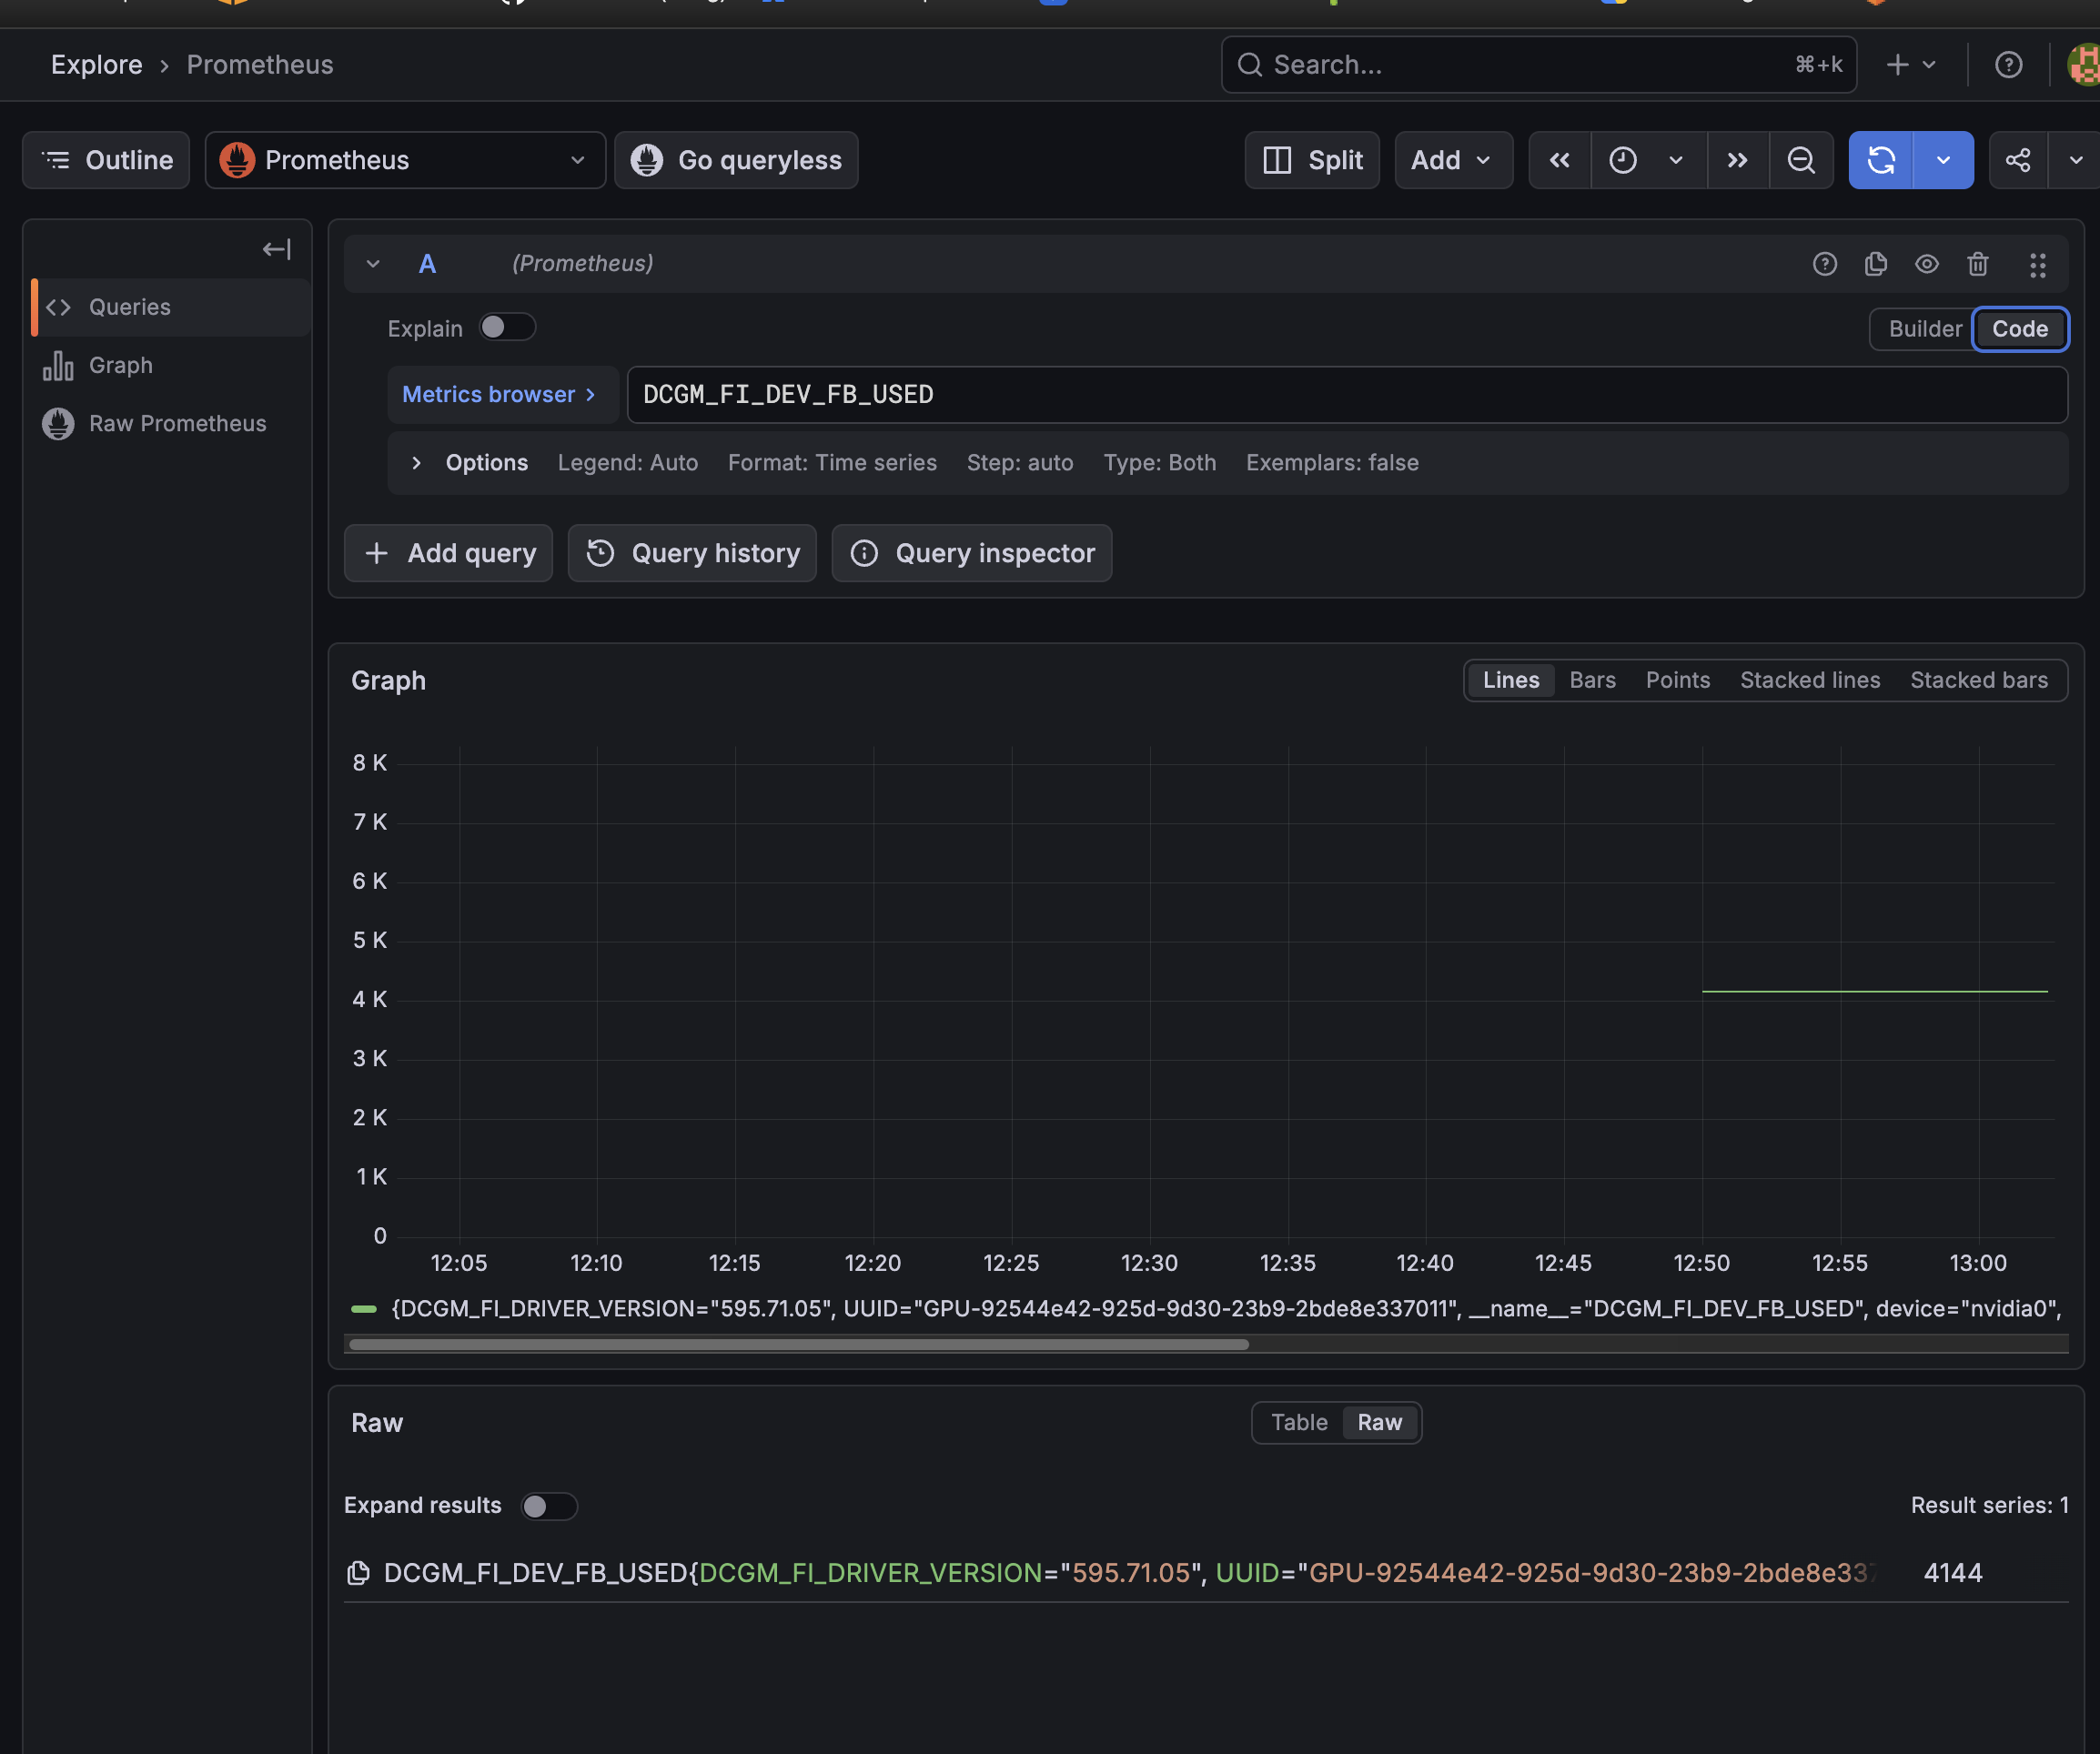
데이터는 멀쩡했다 — DCGM_FI_DEV_FB_USED를 치니 값이 나온다(4144 ≈ 4GB VRAM, 라벨에 GPU UUID·드라이버 버전까지). 즉 DCGM도 Prometheus도 정상이고, 문제는 import한 대시보드의 변수(label_values(...))·datasource uid가 우리 환경과 안 맞아서 패널이 빈 것이었다.
그래서 import를 포기하고, 쿼리를 직접 쓴 커스텀 패널로 다시 만들었다.
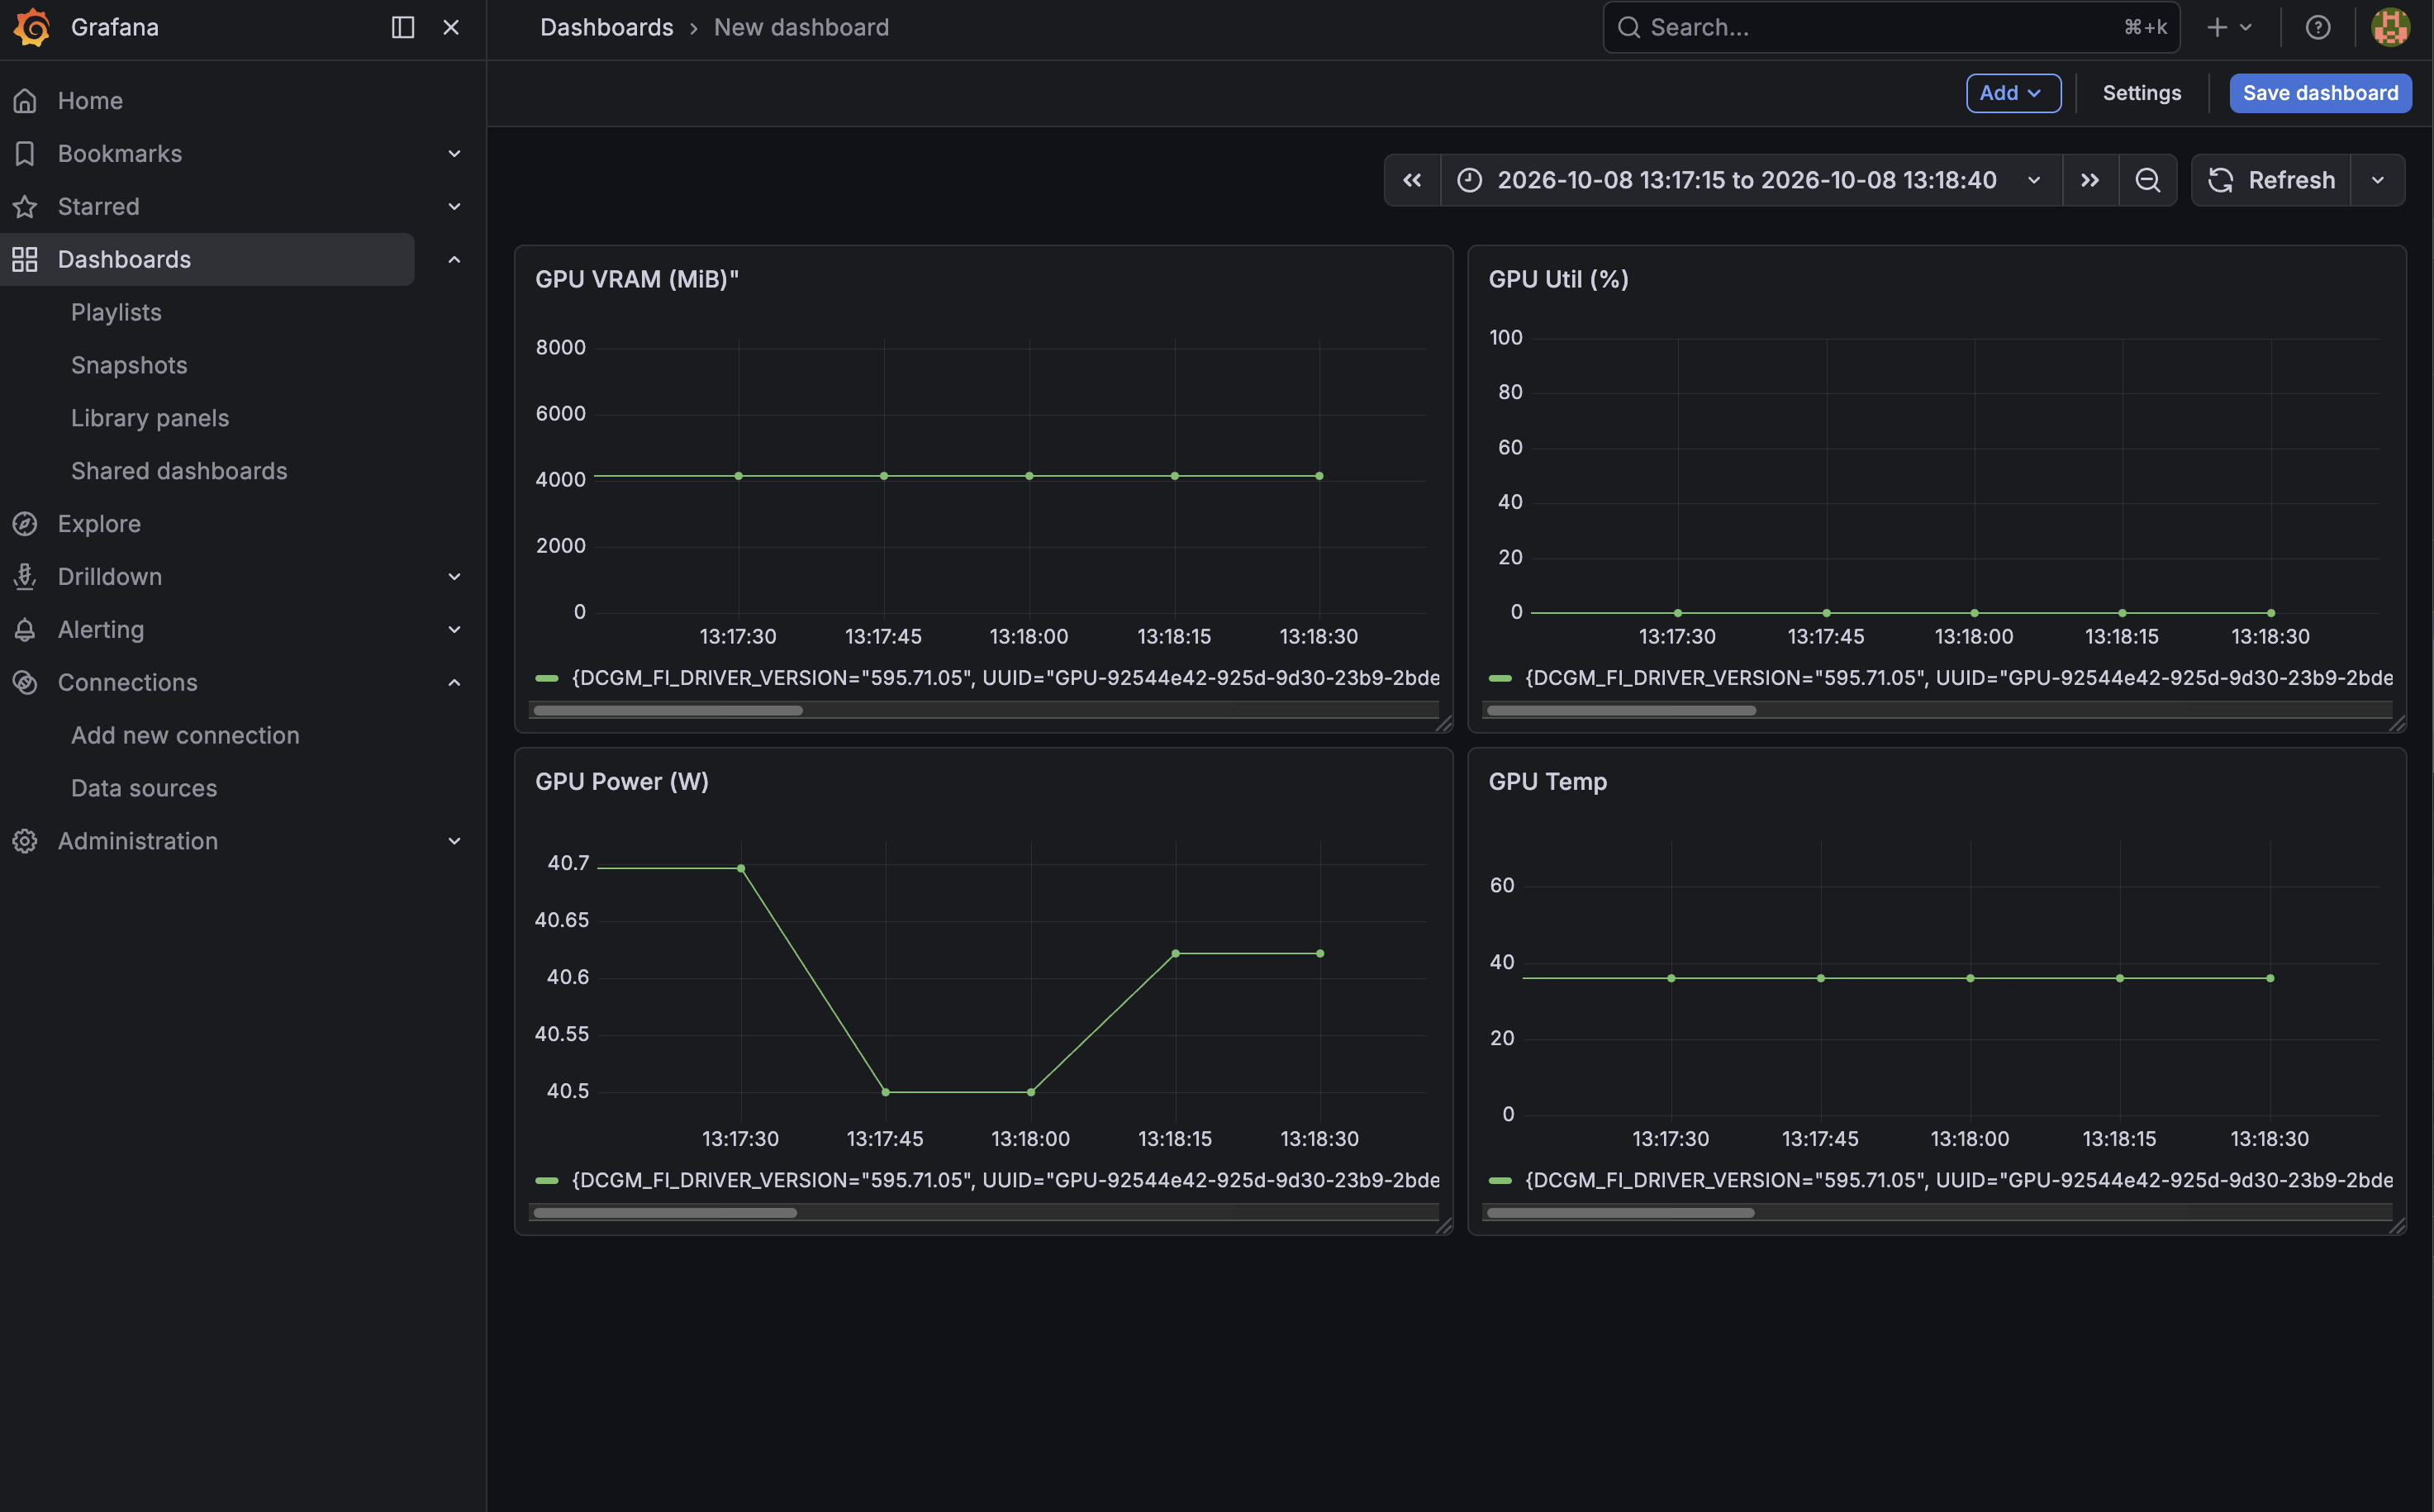
커스텀 GPU 대시보드 — DCGM_FI_DEV_FB_USED(VRAM)·util·power·temp를 직접 쿼리해 패널로. 유휴 baseline: VRAM ~4.1GB(clothes 모델 로드), util 0%, ~40W, 37°C.
교훈 — 공식 대시보드는 “import 한 번이면 끝”일 것 같지만, 변수 쿼리와 datasource uid가 그 대시보드를 만든 환경 기준이라 내 라벨과 다르면 No data가 뜬다. 이럴 때 “데이터가 없나?”를 Explore에서 직접 쿼리로 가르면 빠르다(데이터 O → 대시보드 문제, 데이터 X → 수집 문제). 안 맞는 공식 대시보드를 붙들기보다 쿼리 직접 쓴 커스텀이 확실하다.
그럼 모델(컨테이너)별 GPU는?
DCGM은 전체만 본다. 모델별로 보려면 세 갈래가 있다.
flowchart TB
    Q["모델(컨테이너)별로 보고 싶다"]
    Q --> A["① nvidia-smi — 수동/일회성<br/>프로세스별 VRAM 눈으로 (상시 아님)"]
    Q --> B["② 커스텀 exporter — 상시<br/>밖에서 GPU 엿보고 PID를 컨테이너로 매핑"]
    Q --> C["③ 앱 레벨 — 상시<br/>각 모델 서버가 자기 메트릭 노출"]
- ① nvidia-smi: 박스에서 한 번 치면 프로세스별 VRAM이 바로 보인다. 단 치는 그 순간만 보이는 수동/일회성이라 이력·그래프가 안 남는다
- ② 커스텀 exporter(“밖에서 엿보기”): 별도 프로그램이 NVML로 프로세스별 VRAM을 읽고 PID를 컨테이너로 매핑해 라벨을 붙인다 → GPU 관점은 좋지만 “그게 무슨 작업인지”는 모른다
- ③ 앱 레벨(“앱이 스스로 보고”): 모델 서버 코드가
prometheus_client로 자기 메트릭(추론 지연·처리량·자기가 올린 VRAM)을 노출 → 작업 관점은 최고, 대신 물리 GPU 전체 util은 앱이 모른다
“상시(常時)” = 항상 돌면서 Prometheus가 주기적으로 긁어 이력이 쌓이고 그래프로 남는 것.
nvidia-smi는 그 순간만 보는 수동이라 “상시”가 아니다. 실무는 보통 DCGM(전체) + 앱 레벨(작업별) 조합을 쓴다.
지금은 DCGM(전체) + 필요시 nvidia-smi(눈으로)로 충분하다고 보고, 모델별 상시 수집은 나중에 앱 레벨로 미뤄뒀다.
남는 것
- GPU가 RunPod로 이전하면, 지금의 SG+static 타겟 배선 대신 remote_write(pod가 Prometheus로 push)로 재구성할 계획이다. exporter 구성(DCGM compose)은 그대로 재사용.