Prometheus 풀 스택을 docker compose로 — 파일 4개가 관측을 세운다
mon 전용 박스 하나에 docker compose로 관측 스택을 세웠다. 처음엔 “컨테이너는 떴는데 각 yml이 무슨 뜻인지 몰라 혼자 재구성이 안 되는” 상태였다. 이 글은 파일 4개가 어떻게 맞물리는지와 누가 긁고 누가 저장하는지(pull 모델)를 정리한 것 — 다음엔 보고 안 하고 세울 수 있게.
이 글은 QA 관측 스택 구축기의 ① Prometheus 풀 스택 조각을 자세히 푼 것이다.
파일은 4개, 컨테이너는 여러 개
핵심은 docker-compose.yml만 “실행기”고, 나머지 3개는 각 컨테이너에 주입되는 설정 파일이라는 것.
flowchart TB
    DC["docker-compose.yml<br/>(무엇을 띄울지 = 실행기)"] -->|실행| C["컨테이너들<br/>node-exporter · cAdvisor · prometheus · alertmanager"]
    PY["prometheus.yml (뭘 긁을지)"] -.주입.-> C
    AR["alert.rules.yml (언제 울릴지)"] -.주입.-> C
    AM["alertmanager.yml (어디로 보낼지)"] -.주입.-> C
    C --> FLOW["exporter 노출 → prometheus 긁기 → grafana 그림 / alertmanager 통지"]
docker-compose.yml= 기성 이미지로 컨테이너 실행 (내 이미지를 빌드할 때만 Dockerfile이 필요하고, 여긴 전부 공개 이미지라 불필요)- 나머지 3개는 설정 파일 → compose의
volumes로 컨테이너 안에 주입된다
처음 세울 땐 grafana도 같이 5개로 띄웠다. 이후 팀원 Grafana로 일원화하며 로컬 grafana는 은퇴시켰다(QA 관측 스택 구축기 참고). 아래 compose엔 당시 모습대로 grafana를 포함해 둔다.
docker-compose.yml 줄별
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
services:                                   # 띄울 컨테이너들의 목록
  node-exporter:                            # 서비스 이름(= compose 내부 DNS 호스트명)
    image: prom/node-exporter:latest
    container_name: node-exporter
    restart: unless-stopped                 # 크래시·재부팅 시 자동 재시작
    command:                                # 컨테이너 안 프로그램에 줄 플래그
      - '--path.procfs=/host/proc'          #   호스트 /proc을 여기서 읽기(CPU/메모리)
      - '--path.sysfs=/host/sys'            #   호스트 /sys
      - '--path.rootfs=/rootfs'             #   호스트 디스크(용량)
      - '--collector.filesystem.mount-points-exclude=^/(sys|proc|dev|host|etc)($$|/)'  # 가짜 마운트 제외
    volumes:                                # 호스트 폴더 ↔ 컨테이너 폴더 연결(바인드 마운트)
      - /proc:/host/proc:ro                 #   ro = 읽기전용
      - /sys:/host/sys:ro
      - /:/rootfs:ro
    ports:
      - "9100:9100"                         # "호스트:컨테이너"

  cadvisor:
    image: gcr.io/cadvisor/cadvisor:latest  # 컨테이너별 메트릭 수집기
    container_name: cadvisor
    restart: unless-stopped
    privileged: true                        # 컨테이너/커널 정보 접근 권한
    devices:
      - /dev/kmsg                           # cAdvisor가 요구하는 커널 로그 장치
    volumes:
      - /:/rootfs:ro
      - /var/run:/var/run:ro
      - /sys:/sys:ro
      - /var/lib/docker/:/var/lib/docker:ro # 컨테이너 메타데이터
    ports:
      - "8080:8080"

  prometheus:
    image: prom/prometheus:latest
    container_name: prometheus
    restart: unless-stopped
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml:ro      # 설정 주입(바인드)
      - ./alert.rules.yml:/etc/prometheus/alert.rules.yml:ro    # 규칙 주입(바인드)
      - prometheus-data:/prometheus                            # 수집 데이터 영구 저장(named volume)
    ports:
      - "9090:9090"

  alertmanager:
    image: prom/alertmanager:latest
    container_name: alertmanager
    restart: unless-stopped
    volumes:
      - ./alertmanager.yml:/etc/alertmanager/alertmanager.yml:ro
    ports:
      - "9093:9093"

volumes:                                    # named volume 선언
  prometheus-data:                          # Prometheus TSDB 보관
몇 가지가 처음엔 헷갈렸다.
- volumes가 두 종류다.
/proc:/host/proc·./prometheus.yml:...처럼 내 파일/폴더를 연결하는 건 바인드 마운트,prometheus-data:/prometheus처럼 Docker가 관리하는 영구 저장소는 named volume. 전자는 “내 설정 주입”, 후자는 “데이터 보존”이 목적. - node_exporter의
--path.*: node_exporter는 컨테이너 안에서 도는데, 봐야 할 건 호스트의 상태다. 그래서 호스트/proc·/sys·/를 컨테이너 안(/host/proc등)에 마운트하고, 플래그로 “진짜 호스트 경로는 여기야”라고 알려준다. ports: "9100:9100"는호스트:컨테이너. 왼쪽(호스트)으로 들어오면 오른쪽(컨테이너)으로 넘긴다.
누가 긁고 누가 저장하나 — pull 모델
처음엔 “exporter가 Prometheus로 보내주고, 저장도 각자 하나?” 싶었는데 반대였다.
flowchart LR
    P["Prometheus"] -->|"scrape_interval(15s)마다 HTTP GET = 당기기(pull)"| T["타겟 :9100/metrics"]
    T -->|"메트릭 텍스트 전부 응답"| P
    P --> STORE["TSDB(내장 시계열 DB)에 저장"]
- pull(당기기): Prometheus가 먼저 가서 타겟의
/metrics를 HTTP GET으로 긁어온다. 타겟이 보내주는 push가 아니다. 그래서 대상이 늘면 “누구를 긁을지”만 Prometheus에 추가하면 된다. /metrics는 프론트 페이지가 아니다. 브라우저로 열면 디자인 없이 글자만 주르륵 — 기계(Prometheus)가 파싱할 텍스트다. 사람용 화면은 Grafana.- 무엇을: 그 타겟
/metrics의 모든 메트릭 줄을 통째로 가져온다(하나만 고르는 게 아니라).
역할을 한 번 더 정리하면 — Prometheus가 중심이다.
flowchart LR
    EXP["node_exporter · cAdvisor<br/>= 노출만 (저장 X)"] -->|pull| PROM["Prometheus<br/>긁기 + TSDB 저장 + 규칙 평가 + 발화"]
    PROM -->|"발화한 알럿 전송"| AM["Alertmanager<br/>받아 묶고 통지만"]
    PROM -->|PromQL 질의| G["Grafana = 시각화"]
수집·저장·규칙평가·발화는 전부 Prometheus가 한다. exporter(node/cadvisor)는 노출만(저장 X), Alertmanager는 통지만(TSDB 안 봄, 평가 X), Grafana는 그림만. “수집은 Grafana가 한다”가 아니다 — Grafana는 Prometheus에 질의해서 그릴 뿐이다.
prometheus.yml: 뭘 긁고, 알럿은 어디로
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
global:
  scrape_interval: 15s          # 기본: 모든 타겟을 15초마다 긁음

rule_files:                     # 평가할 알럿 규칙 파일
  - /etc/prometheus/alert.rules.yml

alerting:                       # 발화한 알럿을 보낼 Alertmanager
  alertmanagers:
    - static_configs:
        - targets: ['alertmanager:9093']

scrape_configs:                 # 긁을 대상(job) 목록
  - job_name: prometheus
    static_configs:
      - targets: ['localhost:9090']        # 자기 자신(self-monitoring)
  - job_name: node
    static_configs:
      - targets: ['node-exporter:9100']    # 호스트 메트릭
  - job_name: cadvisor
    static_configs:
      - targets: ['cadvisor:8080']         # 컨테이너 메트릭
job_name은 그 묶음에 붙는job라벨이 된다(“이게 node냐 cadvisor냐”를 나중에 가르는 기준 — exporter가 아니라 Prometheus가 찍는다).- 지금은 targets가 전부 로컬이라 자기 자신만 감시한다. 대상을 늘리려면 여기에
job_name+targets: ['IP:포트']한 묶음을 더한다. 다른 호스트라 서비스 이름이 아닌 IP로. - 대상이 고정 소수면 위처럼
static_configs, 자동 증감(예: ASG)이면*_sd_config(service discovery)를 쓴다 — 백엔드는 ASG라ec2_sd로 갔다([백엔드 ASG 관측]은 별도 글).
이렇게 세우고 나면 Prometheus의 Status → Targets에서 긁는 대상이 보인다.
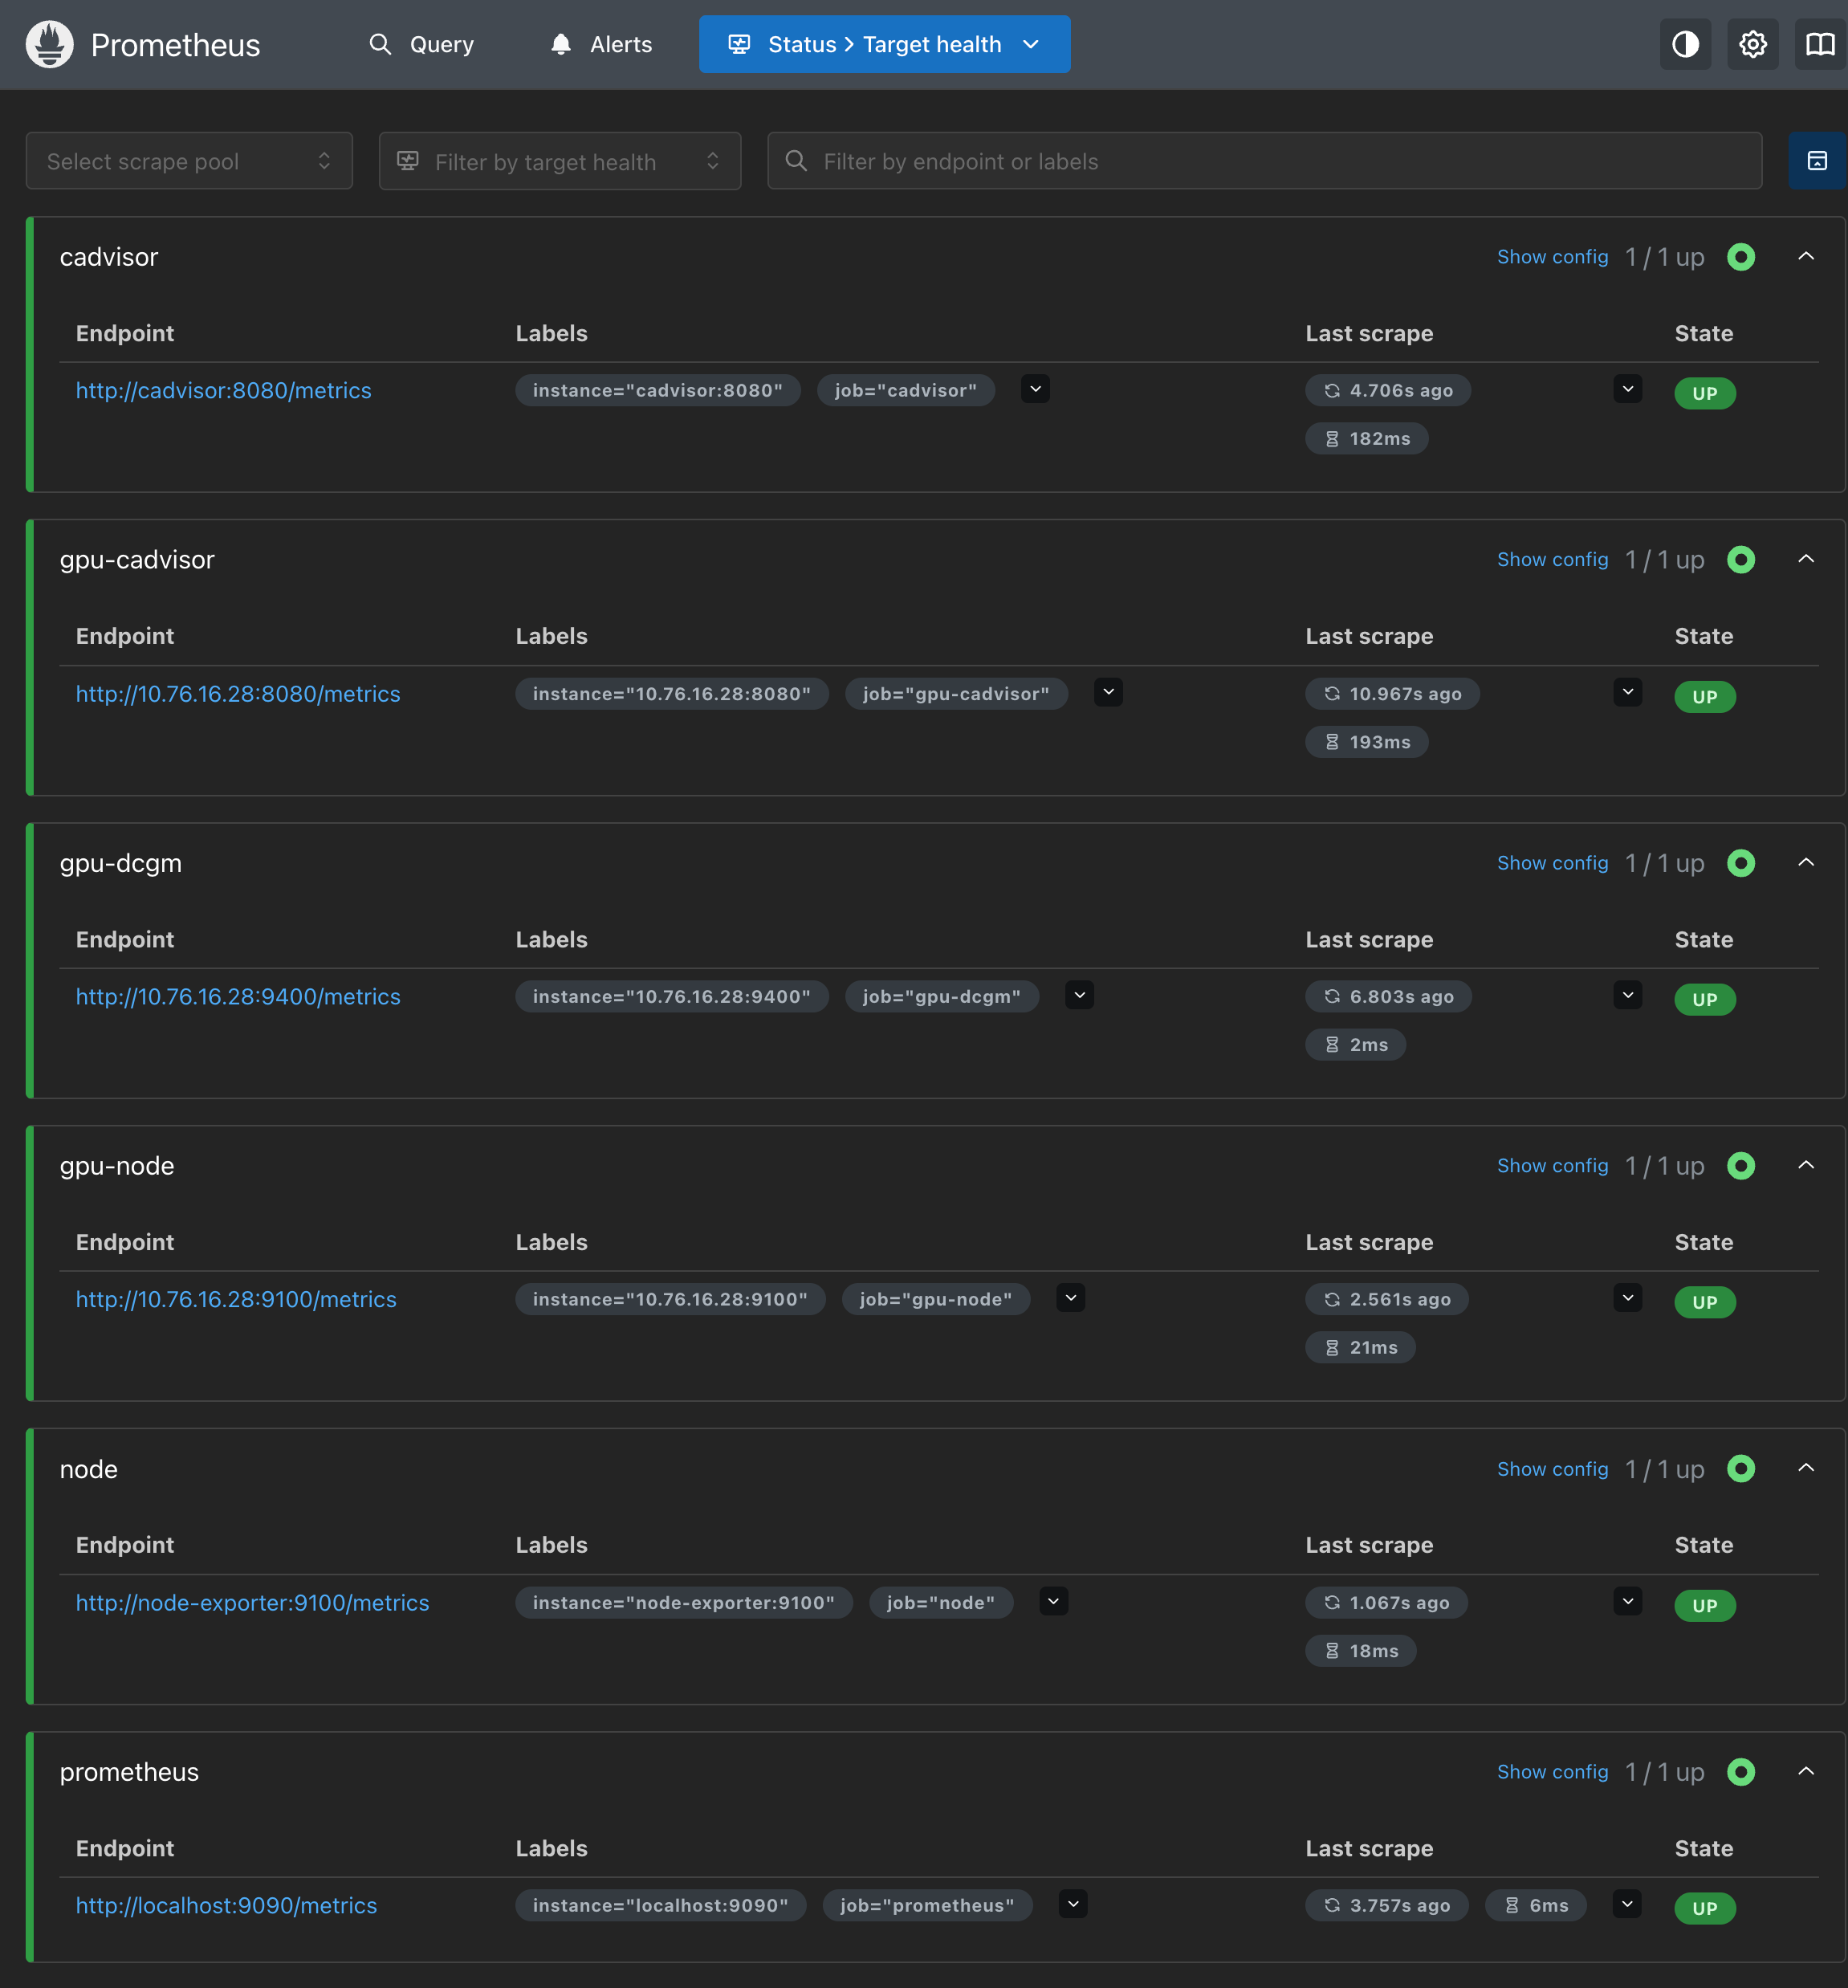
Target health — 각 job이 /metrics를 긁어 UP 상태. 뒤에 GPU·백엔드를 붙이며 이 목록이 늘어난다.
대시보드: 가져오거나, 직접 그리거나
Grafana는 Prometheus를 datasource로 삼아 질의해서 그린다. 대시보드는 두 길이 있다.
- import: 커뮤니티 대시보드 번호(예: node_exporter용 1860)로 가져오기 — 빠르다
- 직접: 패널마다 PromQL을 써서 만들기 — 번거롭지만 내 라벨/환경에 정확히 맞는다
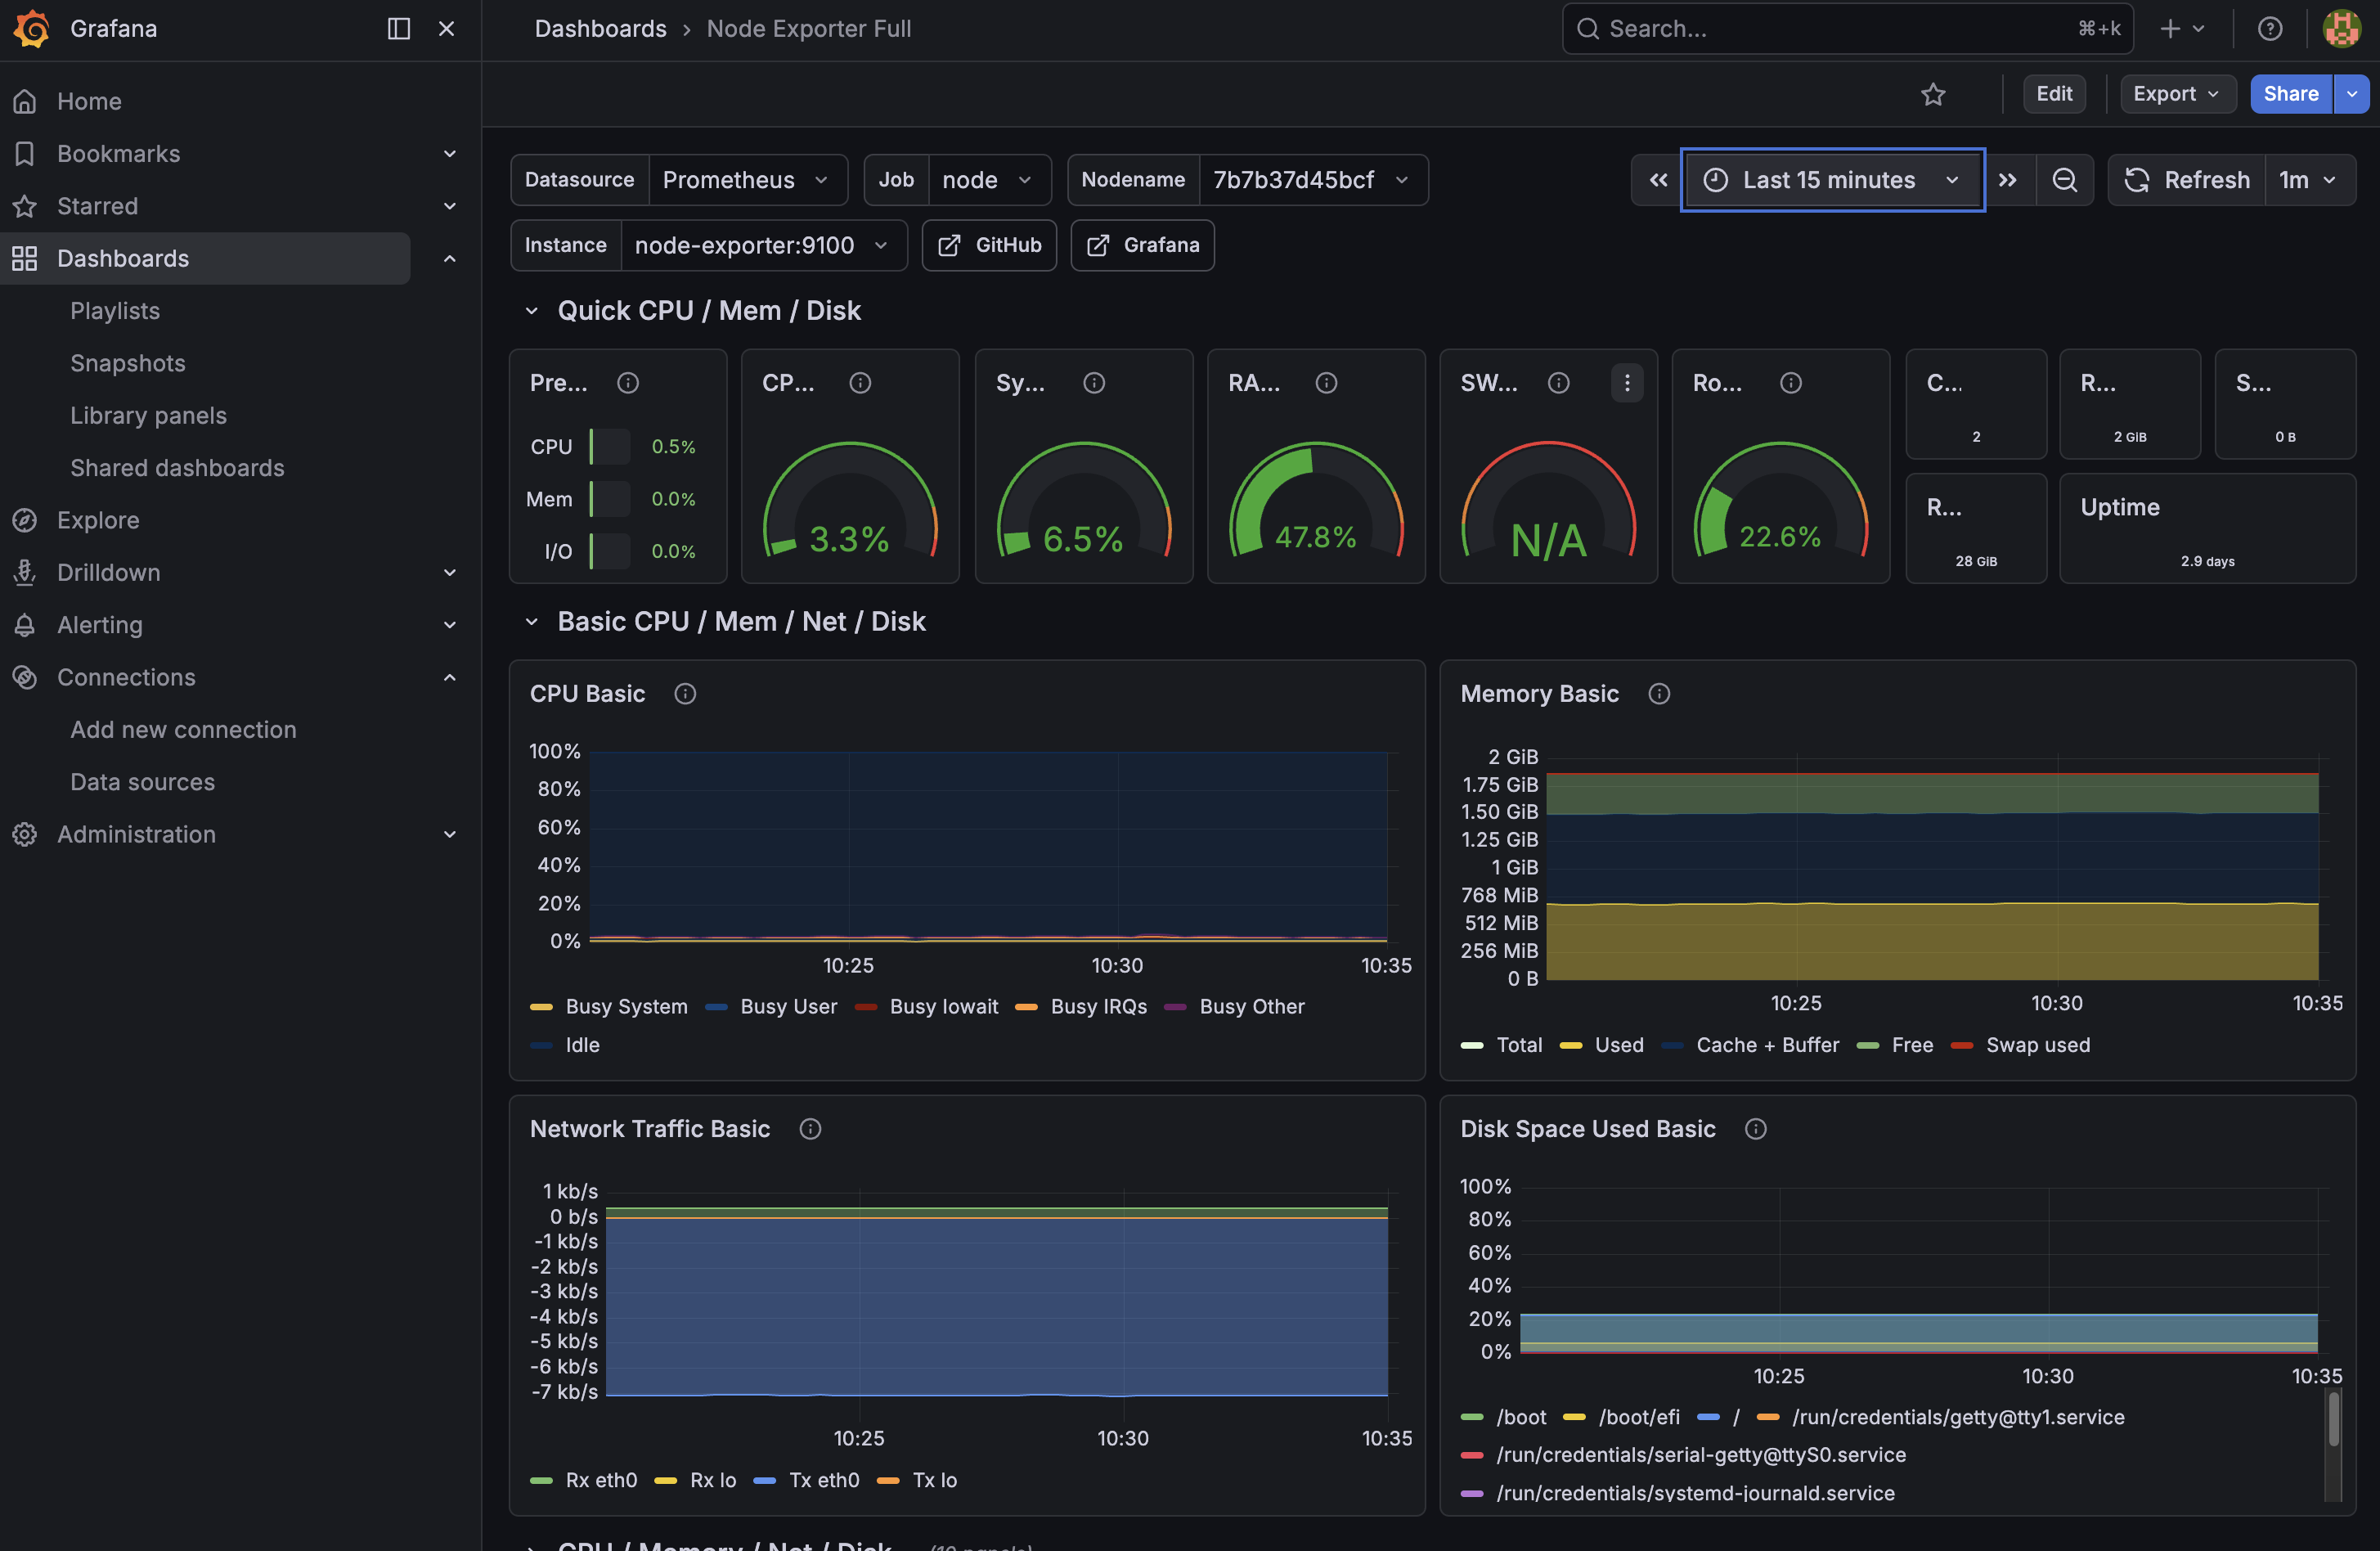
1860 (Node Exporter Full) — import 한 번으로 호스트 CPU/메모리/디스크/네트워크가 다 보인다. (import가 환경과 안 맞아 No data가 날 때의 대처는 GPU 관측 글에서 겪었다)
남는 것
- 이 스택은 mon 박스 자신만 감시하는 데서 시작했다. 이후 GPU 박스(node·cadvisor·DCGM)와 백엔드 ASG(ec2_sd)를 타겟으로 붙여 넓혔다.
- grafana는 팀원 Grafana로 일원화하며 은퇴 → mon 박스엔 지금 prometheus·alertmanager·node·cadvisor 4개만 남아 있다.