두 VPC를 잇고 메트릭을 꽂다 — VPC 피어링 · datasource · 관리형은 CloudWatch
QA에 세운 Prometheus를 팀원이 운영하는 observability VPC의 Grafana에 합쳤다. mon 박스를 통째로 옮기지 않고, Prometheus를 datasource로 “꽂는” 쪽을 택했다. 그 과정에서 배운 VPC 피어링의 조건, datasource는 주소록일 뿐이라는 것, 그리고 관리형(RDS)은 왜 CloudWatch로 보나를 정리한다.
이 글은 QA 관측 스택 구축기의 ② obs VPC 연결 조각을 자세히 푼 것이다.
관측성 3기둥 — Grafana는 “한 창”일 뿐
처음엔 팀원 VPC가 “메트릭 보는 박스”인 줄 알았는데, Grafana가 Loki·CloudWatch를 datasource로 들고 있었다. 관측성은 보는 각도가 다른 셋을 합쳐 부르는 말이고, Grafana는 그걸 한 화면에 띄우는 도구다(저장은 안 한다).
flowchart TB
    M["Metrics · 숫자/추이<br/>Prometheus (내 QA 스택)"]
    L["Logs · 사건/상세<br/>Loki"]
    T["Traces · 요청 여정<br/>Tempo"]
    M --> G["Grafana = 한 창 (single pane)<br/>저장 X · 질의만"]
    L --> G
    T --> G
- Metrics(Prometheus) = “얼마나 느린가, CPU 몇%” — 내가 QA에 세운 스택
- Logs(Loki) = “그 순간 무슨 일이 있었나”
- Traces(Tempo) = “이 요청이 어느 구간에서 시간을 썼나”
datasource는 “주소록”이지 자료 본체가 아니다
Grafana 박스의 yaml에 Loki가 적혀 있다고 로그 본체가 Grafana에 있는 게 아니다. 그건 “Loki는 저기 가서 물어봐”라는 포인터(주소록)다. 실제로 세어보니 observability VPC엔 Grafana + loki-tempo 딱 2대였고, 로그 본체는 loki-tempo 박스에 있었다.
flowchart LR
    subgraph GB["grafana 박스 (10.78.8.185)"]
        CFG["observability.yaml<br/>url: loki...internal:3100<br/>= 주소록(포인터)"]
    end
    subgraph LB["loki-tempo 박스 (10.78.8.77)"]
        LOKI["Loki 본체 :3100<br/>실제 저장·질의"]
    end
    CFG -. 내부 DNS로 질의 .-> LOKI
그리고 그 Grafana의 datasource엔 Loki·CloudWatch만 있고 Prometheus가 없었다 — 메트릭 기둥이 비어 있던 것. 그 빈자리에 내 Prometheus를 꽂으면 그림이 완성된다.
통째 이전 대신 “꽂기” — 왜
두 선택지가 있었다. (A) Prometheus를 QA에 두고 datasource로 연결 / (B) mon 박스를 observability VPC로 이전. 확인해보니 B는 지금 불가능했다.
- observability의 프라이빗 서브넷엔 NAT도 SSM 엔드포인트도 없어서, 거기 올린 박스는 밖으로 못 나가고(이미지 pull 불가) SSM 접속도 안 됐다. → 옮겨도 들어갈 수조차 없음
- 게다가 mon 박스엔 내 Grafana도 있어서, 옮기면 Grafana가 2개가 돼 중복
→ 결정: A. Prometheus는 QA에 두고, 팀원 Grafana가 피어링을 넘어 질의하게 했다. scrape(15초)는 QA 로컬에 두는 게 피어링을 덜 타서도 유리하다.
두 VPC는 이미 VPC 피어링으로 이어져 있었는데, 여기서 중요한 걸 배웠다 — “피어링 active”만으로는 통신이 안 된다.
flowchart LR
    subgraph O["observability VPC 10.78"]
        G["Grafana"]
    end
    subgraph Q["QA VPC 10.76"]
        P["Prometheus :9090"]
    end
    G ===|"pcx (피어링)"| P
피어링으로 통신하려면 조건 3개가 다 맞아야 한다 — ① pcx(피어링 연결)가 active ② 양쪽 라우트 테이블에 상대 CIDR→pcx(obs엔
10.76→pcx, QA엔10.78→pcx) ③ 받는 쪽 SG 허용. 그리고 CIDR이 안 겹쳐야(10.78 vs 10.76). 특히 ②라우트가 없으면 active여도 패킷이 안 넘어간다.
연결 — datasource yaml + 크로스-VPC SG
팀원은 datasource를 UI 클릭이 아니라 provisioning 파일로 관리하고 있었다. 그래서 나도 그 파일에 Prometheus 한 덩어리를 추가했다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
apiVersion: 1
datasources:
  - name: Loki
    uid: loki
    type: loki
    url: http://loki.observability.myton.internal:3100
    isDefault: true
  - name: CloudWatch
    uid: cloudwatch
    type: cloudwatch
    jsonData: { authType: default, defaultRegion: ap-northeast-2 }
  - name: Prometheus          # ← 내가 추가한 메트릭 기둥
    uid: prometheus
    type: prometheus
    access: proxy
    url: http://10.76.8.139:9090   # QA mon 박스 사설 IP (피어링으로 닿음)
    isDefault: false
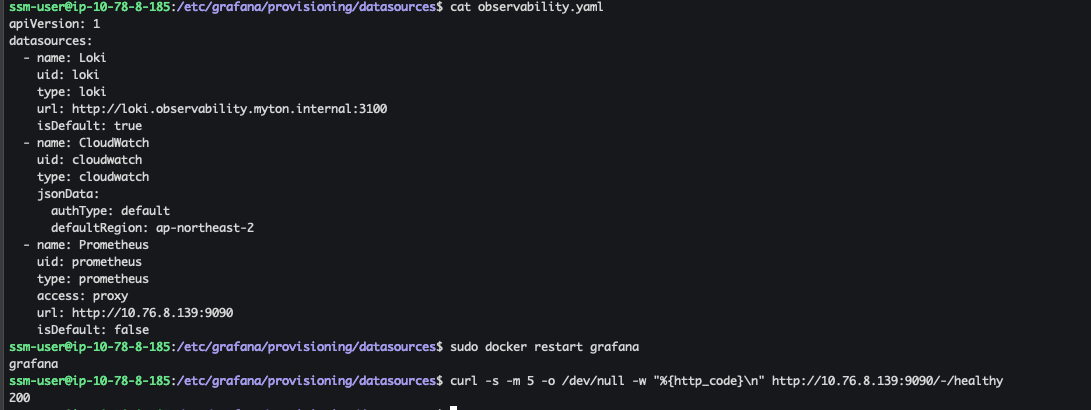
연결 + 검증 — yaml에 Prometheus를 추가하고 docker restart grafana, 그다음 Grafana 박스에서 curl http://10.76.8.139:9090/-/healthy → 200. 즉 observability의 Grafana가 피어링을 넘어 QA의 Prometheus에 실제로 닿았다.
네트워크/권한의 포인트는 “받는 쪽에 상대 주소를 허용”이다 — 질의를 받는 Prometheus 박스의 SG inbound에 Grafana(10.78)에서 오는 9090을 열었다. (exporter를 scrape할 때랑 방향만 반대고 원리는 같다. IP가 아니라 SG 참조로 열어 인스턴스가 바뀌어도 유지)
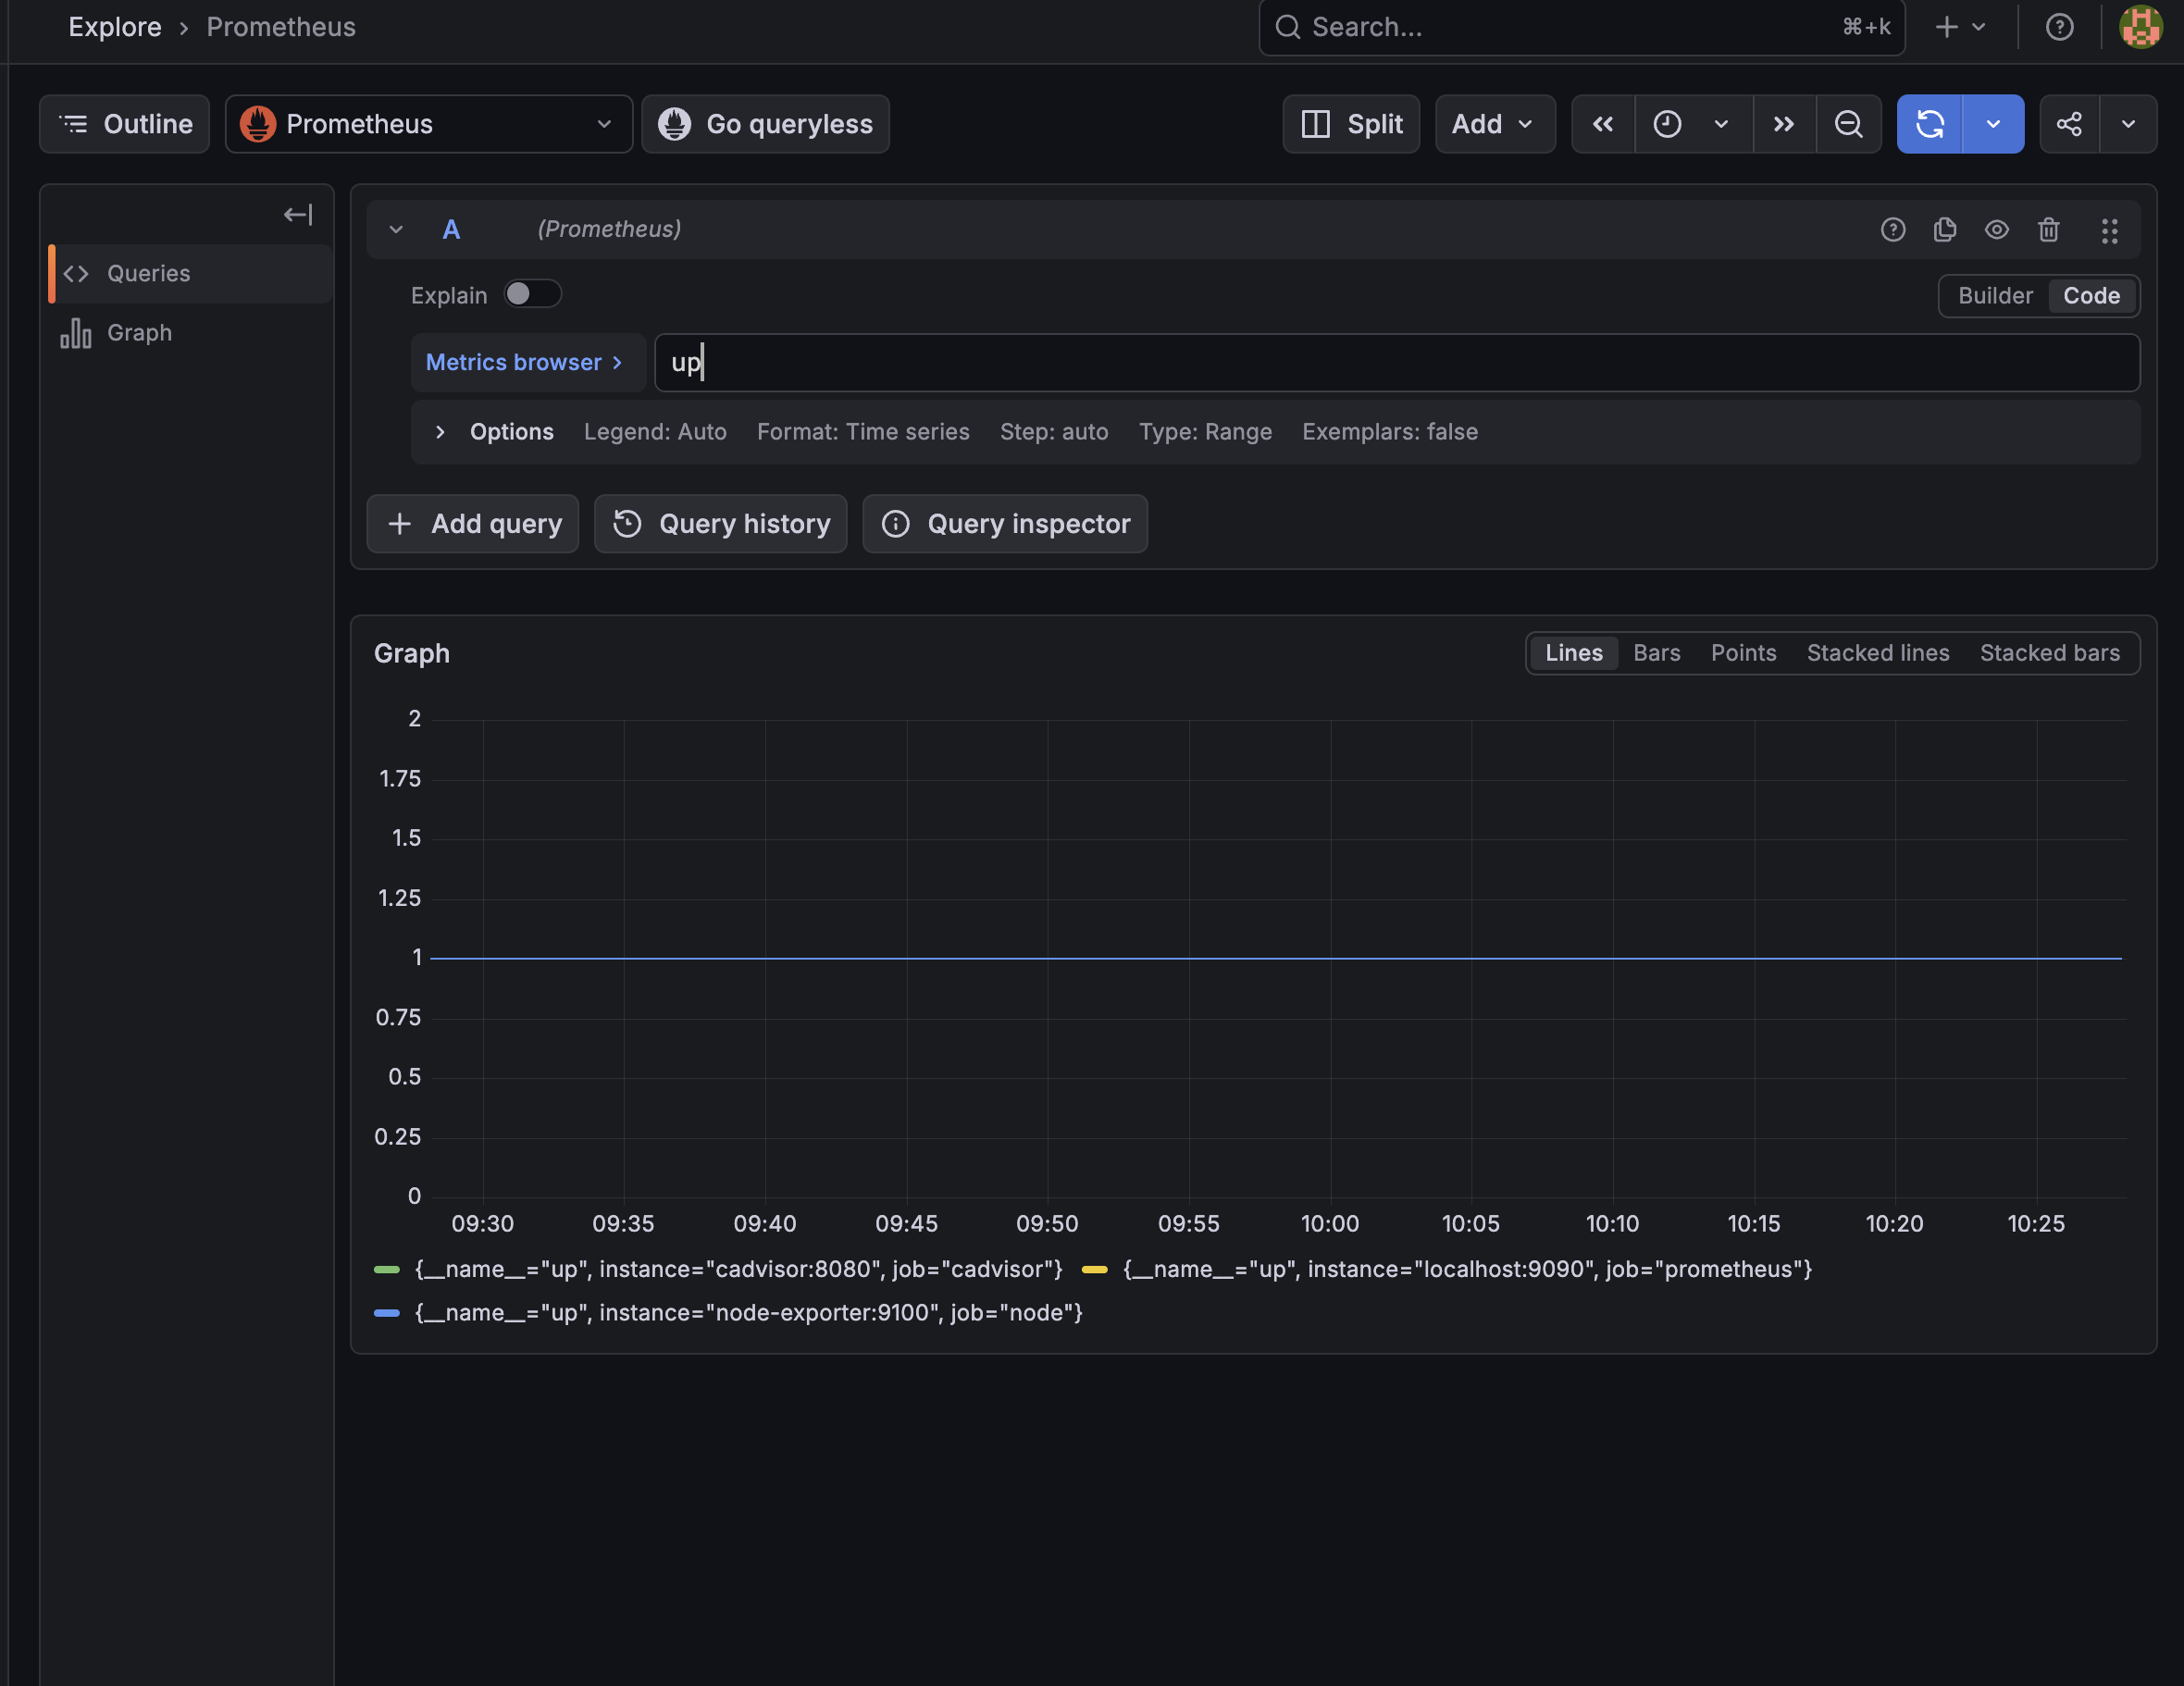
Grafana에서 확인 — datasource Test 통과 후 Explore에서 up을 치니 QA 타겟이 보였다. 메트릭 기둥이 채워진 것.
관리형 서비스(RDS)는 CloudWatch로 본다
팀원이 “RDS는 CloudWatch로 본다”고 했는데 처음엔 “CloudWatch는 로그 보는 거 아니었나?” 싶었다. 두 가지를 바로잡았다.
- CloudWatch는 로그 전용이 아니다 — Metrics(AWS판 Prometheus) + Logs(AWS판 Loki)를 다 하는 AWS 관측성 우산이다
- RDS는 관리형이라 호스트 접근이 안 된다 → node_exporter 같은 에이전트를 못 꽂는다 → 그래서 AWS가 지표를
AWS/RDS네임스페이스로 CloudWatch에 자동 발행한다. 그걸 보는 것(CPU·연결 수·여유 스토리지·IOPS·지연 등)
flowchart TB
    E["EC2 (내가 관리)"] -->|"에이전트 직접 설치"| P["Prometheus·Loki"]
    R["RDS·ELB·Lambda (AWS 관리)"] -->|"AWS가 자동 발행"| CW["CloudWatch (메트릭+로그)"]
    P --> G["Grafana = 한 창 (datasource로 모두 질의)"]
    CW --> G
도구 선택 기준은 “호스트에 내 에이전트를 꽂을 수 있나” 하나다. 되면 Prometheus/Loki(직접 수집), 안 되면(관리형) CloudWatch(AWS가 대신 발행). Grafana가 datasource로 둘 다 한 창에 모은다. 그래서 팀원 Grafana에 CloudWatch가 이미 있던 것 + 내 Prometheus를 더하니 메트릭이 완성됐다.
남는 것
- datasource는 Grafana 박스의 provisioning yaml로 넣어 재시작에도 살아남지만, 호스트를 직접 편집한 거라 박스를 CloudFormation으로 통째 재배포하면 다시 넣어야 한다(이상적으론 팀원 템플릿에 반영).
- 로그 기둥(Loki)엔 내가 설계한 로그 공통 스키마가 들어간다 — 그건 별도 작업.